چرا کد، وقتی هوش مصنوعی هست؟
سخنرانیای دربارهٔ هوش مصنوعی و کدنویسی
این سخنرانی را دربارهٔ احساسم نسبت به هوش مصنوعی و کدنویسی بارها ایراد کردهام (آخرین بار برای یک وبینار انجمن آمار آمریکا، ASA) و به این نتیجه رسیدهام که باید دست از ارائهٔ آن بردارم و سراغ کار تازهای بروم. برای اینکه خودم را مجبور به این کار کنم، آن را برای شما مکتوب کردهام 🙂.
پیش از ورود به بحث، شاید جالب باشد که فرایند تهیهٔ این متن را بدانید، چون آن هم بهشدت به هوش مصنوعی تکیه دارد:
- کار را با این شروع کردم که از Claude خواستم ویدیو را از یوتیوب دانلود کند، چون هیچوقت یادم نمیماند خودم چطور باید این کار را بکنم.
- سپس با MacWhisper یک رونوشت (transcript) از گفتار ساختم و اسلایدهای ارائهٔ Keynote خودم را بهصورت تصاویر PNG جداگانه ذخیره کردم.
- بعد چند دور پاکسازی را با Claude انجام دادم: ابتدا از او خواستم اسلایدهایم را بخواند تا بداند چه اصطلاحاتی به کار میبرم، سپس خواستم خطاهای رونویسی را اصلاح کند، متن را به پاراگرافها تقسیم کند و ناروانیهای گفتار (مثل «اِ»، «اوم» و مانند آن) را حذف کند. از git استفاده کردم و هر مرحله را کامیت کردم تا دقیقاً ببینم او چه کرده است.
- پس از آن، رونوشت متنی ساده را به مارکداون (markdown) تبدیل کردم، آن را با پیوندها غنی ساختم و از او خواستم اسلایدها را در جای مناسب درج کند (که شگفتآور خوب انجام داد).
- در این مرحله متوجه شدم که در سخنرانی یک نمایش زنده (دمو) داشتهام و بخش بلندی از متن بدون اسلاید مانده است. پس از Claude خواستم بر اساس زماننگاریهای رونوشت اصلی، از ویدیو تصویر صفحه (اسکرینشات) استخراج کند.
- در پایان، یک بازخوانی دقیق شخصی انجام دادم و متن را اندکی ویرایش کردم تا آنچه را که واقعاً منظورم بود منعکس کند، نه آنچه را که گفته بودم.
رویهمرفته حدود یک ساعت کار بود که پیش از این هرگز به این سرعت ممکن نبود!
امروز میخواستم دیدگاهم را دربارهٔ هوش مصنوعی با شما در میان بگذارم. من کسی هستم که زیاد کد مینویسد و هوش مصنوعی شیوهٔ تولید بستههای R را برایم واقعاً تغییر داده است، اما همچنان از اساس معتقدم کد بسیار مهم است. پس دربارهٔ همین موضوع صحبت خواهیم کرد.
تصویر کلان
میخواهم از تصویر کلان شروع کنم. نخستین نکته این است که فرقی نمیکند دربارهٔ هوش مصنوعی چه احساسی دارید؛ غول از چراغ جادو بیرون آمده و دیگر به آن بازنمیگردد. من هنوز نسبت به هوش مصنوعی احساس دوگانگی بنیادین دارم. بدیهی است که میتواند اهرمی عظیم برای نوشتن کد بهتر باشد، اما جنبههای منفی بسیاری نیز دارد؛ از اثرات زیستمحیطی گرفته تا تمرکز بیشتر ثروت. و همهٔ اینها بر پایهٔ سرقت مالکیت فکری در مقیاسی صنعتی و بیسابقه بنا شده است. پس چیزهای بد بسیاری دربارهٔ هوش مصنوعی وجود دارد و من هنوز از استفادهٔ خودم از آن احساس تعارض میکنم، اما به نظر میرسد چیزی است که همهٔ ما باید با آن کنار بیاییم. میآید، چه بخواهیم چه نخواهیم. نمیتوانیم غول را به چراغ برگردانیم.
اما از سوی دیگر، فکر میکنم میتوان با هوش مصنوعی واقعاً اوقات خوبی داشت. میتواند واقعاً سرگرمکننده و واقعاً توانمندساز باشد.
برای خود من، این موضوع نگاهم را به تولید کد تغییر داد. دیگر این من نیستم که کد را مستقیماً در رایانه تایپ کنم؛ اکنون با یک ربات (در مورد من Claude) گفتگو میکنم که افکارم را تفسیر میکند و حلقهٔ بازخورد تکرارشوندهٔ قابلتوجهی فراهم میآورد که هنوز آن را واقعاً رضایتبخش مییابم.
اما سر یک دوراهی ایستادهایم: دو مسیر پیش روی شماست وقتی از هوش مصنوعی برای تولید کد استفاده میکنید. اولی همان است که احتمالاً بیش از همه در رسانهها دربارهٔ آن میشنوید.
این همان «کارخانهٔ نرمافزار» است که در آن شما مدیر کارخانهای از رباتها میشوید که شبانهروز بیوقفه مشغول کارند و شما دیوانهوار میکوشید هرچه میتوانید ایدهٔ خوب به خوردشان بدهید. اگر این مسیر را به منتهای خود برسانیم، به چیزی کاملاً آخرالزمانی میرسیم.
نمیدانم با Steve Yegge آشنا هستید یا نه؛ او مهندس نرمافزار بسیار شناختهشدهای است. نوشتهٔ او با عنوان «شهر گاز» (Gas Town) آیندهٔ آخرالزمانیای را ترسیم میکند که در آن تنها کاری که میکنید این است که حجم خام کدی را که تولید میکنید بهینه کنید و هر مشکلی را که با عاملها (agents) ایجاد کردهاید با عاملهای بیشتر حل کنید.
اما این تنها راه پیش رو نیست. راهی هم هست که در آن از هوش مصنوعی برای نوشتن کد باکیفیتتر استفاده میکنید، و برای من نمونهٔ بارز آن نوشتههای Doll است.
یکی از چیزهای واقعاً جالب، در حالی که دربارهٔ استفاده از هوش مصنوعی برای مهندسی نرمافزار باکیفیت بیشتر میآموزیم، این است که بسیاری از بهترین روشهای موجود — مثل مستندات خوب، آزمونهای قوی و اهمیت دادن به نحوهٔ سازماندهی کد — همچنان بسیار بسیار مهماند. و خبر خوب این است که اکنون دسترسی به آنها آسانتر از گذشته است. وقتی هزینهٔ نوشتن کد کاهش مییابد، میتوانید زمان بیشتری (یا زمان بیشتری از Claude!) صرف طراحی معماری کدتان کنید تا در آینده فهم و تغییر آن آسانتر باشد.
برای من مهمترین چیزی که باید به آن پایبند بمانیم این است که صرفنظر از اینکه کد چگونه تولید میشود، همچنان کار خود شماست. شما مسئول کاری هستید که با هوش مصنوعی با هم انجام میدهید.
اگر تصمیم بگیرید از نظر فکری درگیر نشوید، میتوانید کارهای متوسط را سریعتر از هر زمان دیگری تولید کنید. اما این تنها گزینه نیست. اگر واقعاً و عمیقاً درگیر شوید، بهراستی معتقدم میتوانید کاری باکیفیتتر از هر زمان پیشین تولید کنید.
در نهایت، فکر میکنم بهترین استعاره برای هوش مصنوعی این است که یک تقویتکننده (amplifier) است. اگر بخواهید تنبل باشید، میتوانید با تلاشی کمتر از هر زمان دیگری در تاریخ بشر تنبلتر باشید؛ میتوانید مسائل را بدون هیچ درگیری فکری حل کنید. اما لازم نیست چنین کنید، چون هوش مصنوعی میتواند بهترینهای شما را هم تقویت کند. میتوانید از آن برای عمیقتر رفتن و درگیر شدن بیشتر در هر حوزهای که در آن کار میکنید استفاده کنید.
برای من، این با نقلقول محبوبم از Tukey همخوانی دارد، آنجا که میگوید آماردانان این امتیاز را دارند که در حیاط خلوت همه بازی کنند. هوش مصنوعی به ما امکان میدهد در حیاط خلوتهای بیشتری بازی کنیم، آن هم با مهارتی بیش از گذشته.
به نظر من این یکی از دلایلی است که آماردانان و دانشمندان داده در این دورهٔ هوش مصنوعی موقعیت خوبی برای موفقیت دارند. ما مهارت برنامهنویسی داریم و این مهارتها اکنون بهشدت تقویت شدهاند — اگر در یک زبان برنامهنویسی بلد باشید، اکنون عملاً میتوانید در هر زبانی برنامه بنویسید. ما یک شکگرایی عمیق و ریشهدار دربارهٔ منشأ دادهها داریم: چه کسی آن را جمعآوری کرده، چرا جمعآوری کرده، و دربارهٔ چه چیزهایی باید نگران باشیم؟ و ما درکی از تغییرپذیری (variation) داریم که به نظرم در مورد مدلهای زبانی بزرگ بسیار مهم است، چون آنها در اساس ماشینهایی تصادفی (stochastic) هستند. پس مدلهای زبانی بزرگ و هوش مصنوعی، به نظر من، تقویتکنندهای عظیماند. قطعاً میتوانید از آنها برای تقویت بدترین جنبههای خودتان استفاده کنید، اما میتوانید برای تقویت بهترین جنبههایتان هم از آنها بهره ببرید.
توصیههای عملی
اکنون میخواهم به سراغ چیزی عملیتر بروم. میخواهم با کمی همسطحسازی شروع کنم؛ برداشت افراد از هوش مصنوعی و مدلهای زبانی بزرگ بسیار متفاوت است و بهترین روشها با سرعتی سرسامآور در حال تغییرند. اگر نظرتان دربارهٔ هوش مصنوعی بر پایهٔ وضعیت شش ماه یا یک سال پیش است، بهشدت منسوخ است. پس میخواهم چند توصیهٔ مشخص دربارهٔ چیزهایی بدهم که من، تیمم و کسانی که با آنها صحبت میکنم بیشترین اثر را در آنها مییابیم.
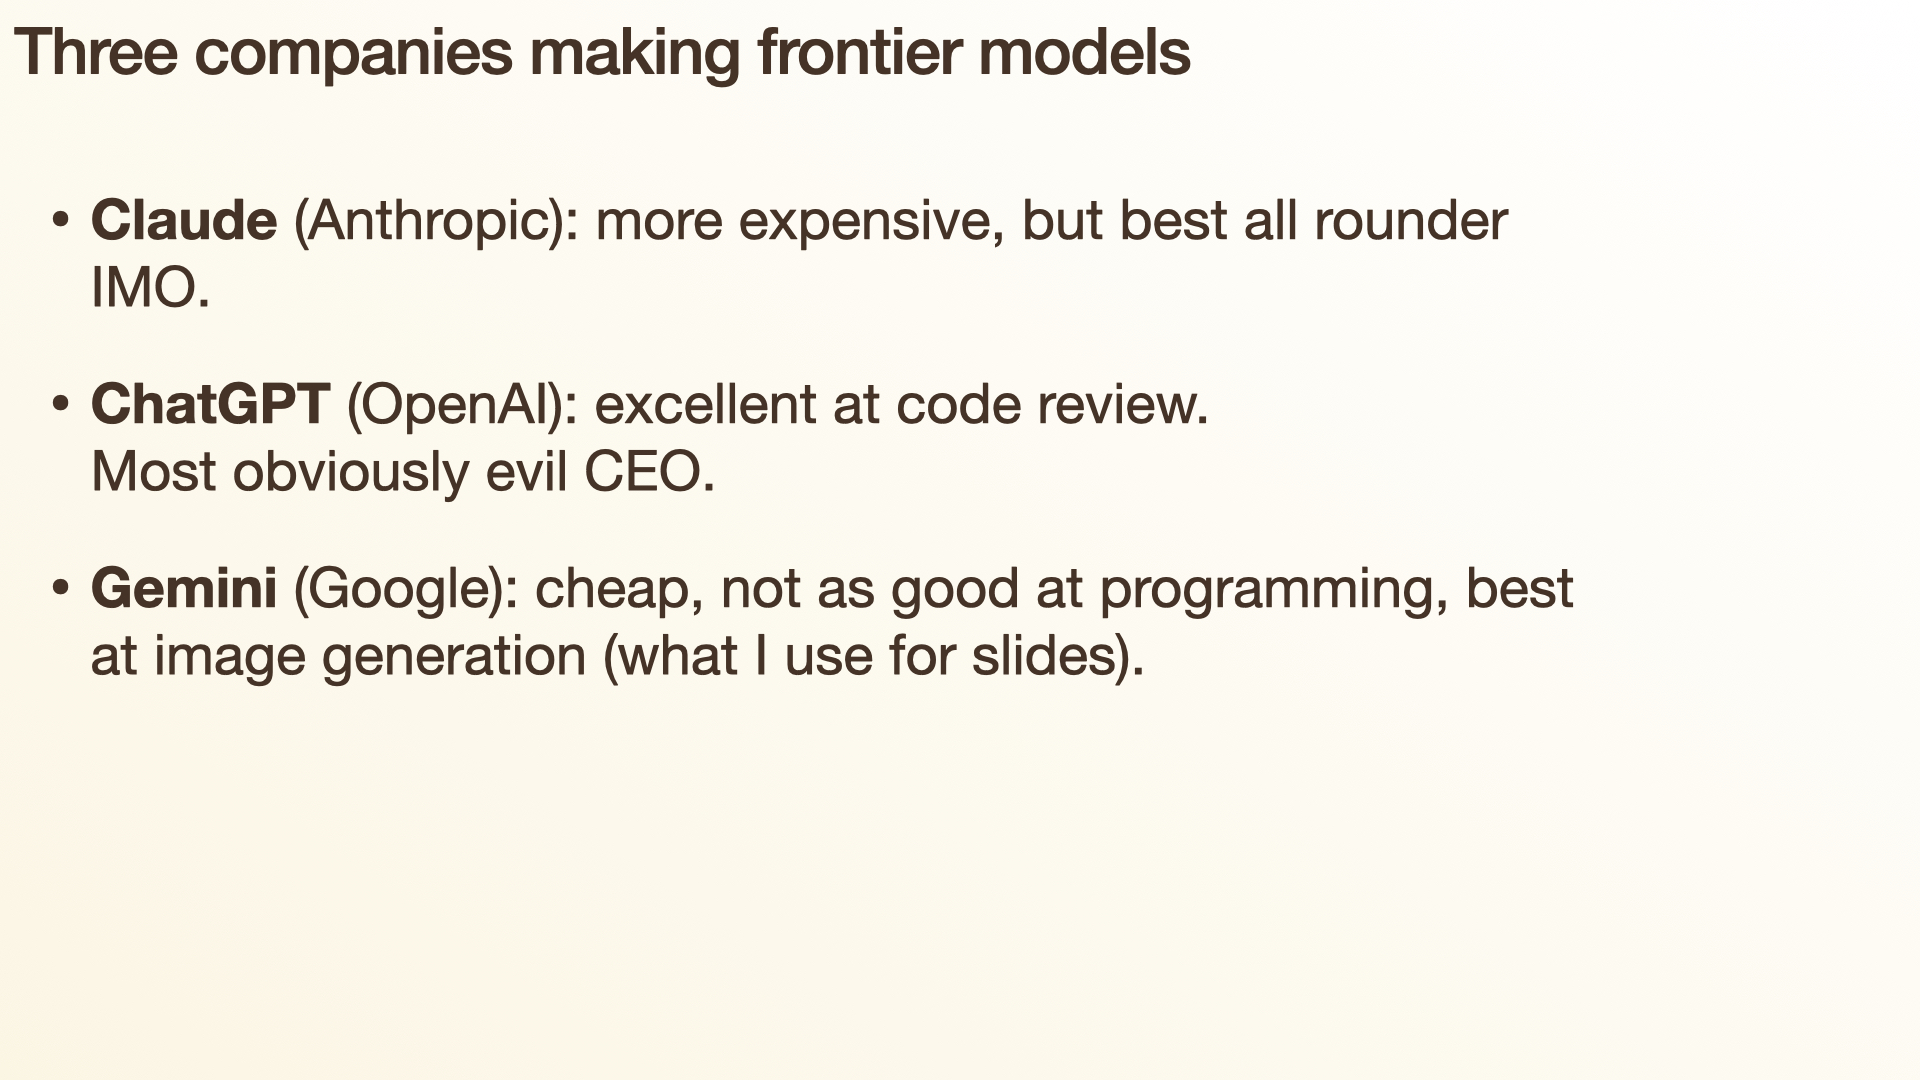
نخست اینکه سه شرکت هستند که بهاصطلاح «مدلهای مرزی» (frontier models)، یعنی بهترینهای بهترینها، را تولید میکنند. اولی، و مورد علاقهٔ شخصی من، Anthropic است که Claude را تولید میکند. این مدل کمی گرانتر از مدلهای دیگر است، اما به نظر من بهترین مدل همهفنحریف است. قطعاً بهترین مدل برای نوشتن کد R است؛ احتمالاً ۹۰٪ کد R که امروز مینویسم را او تولید میکند. پاسخهایش همیشه عالی نیست، اما اغلب بهطرز شگفتآوری نکتهسنجانه و آگاهانه است. در مواقعی هم بهطرز شگفتآوری کودن است، اما بعداً به این موضوع بازمیگردیم و دربارهٔ اینکه چطور از خودتان در برابر این نوع کودنی محافظت کنید صحبت میکنیم.
بعد ChatGPT را داریم که محصول OpenAI است. از همکارانم دربارهٔ آن بسیار نظرهای مثبت میشنوم، بهویژه برای استفاده در بازبینی کد. نقطهٔ ضعف ChatGPT این است که آشکارا شرورترین مدیرعامل را دارد — که البته به این معنا نیست که هیچیک از این مدیران عامل آدمهای خوبی هستند، اما مدیرعامل ChatGPT به نظر میرسد بهطور خاص و آشکارا آدم خوبی نیست.
و در نهایت Gemini از گوگل را داریم. فکر میکنم فعلاً با فاصلهٔ زیادی سوم است. اما این برای شما یک مزیت است: گوگل شدیداً میخواهد مرتبط بماند و پول انبوهی برای خرج کردن دارد، پس اگر میخواهید در هزینه صرفهجویی کنید، Gemini بسیار خوب و ارزان است. طرح رایگان خوبی دارد و میتوانید بدون هزینهٔ زیاد کارهای زیادی با آن انجام دهید. در تولید تصویر هم واقعاً خوب است. همهٔ تصاویری که پیشتر در اسلایدها نشان دادم را با آن ساختهام و البته، چون من هستم، اکنون همهٔ این فرایند در یک بستهٔ R به نام bananarama خودکار شده است.
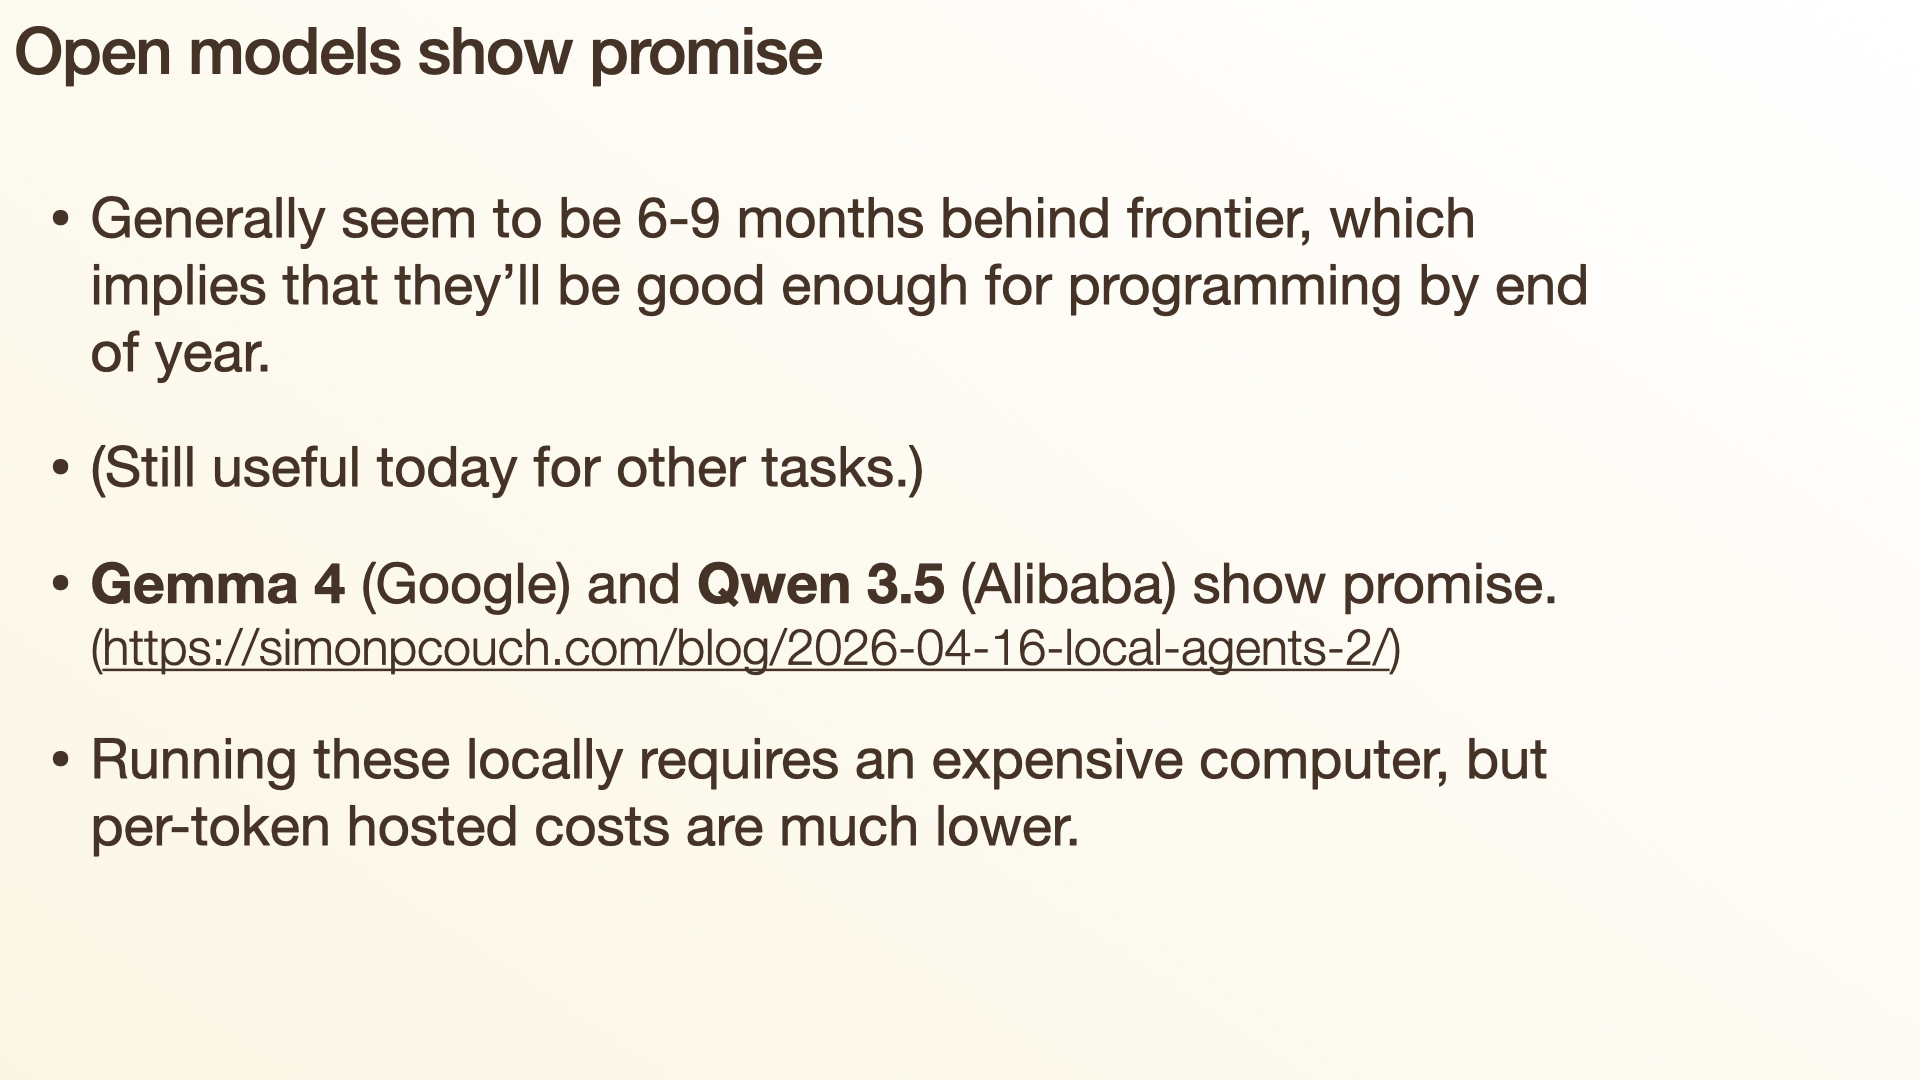
اینها مدلهای مرزیاند — بهترین و گرانترین (هم برای ساخت و هم برای مصرف). در سوی دیگر، «مدلهای باز» (open models) را داریم که گاهی «مدلهای محلی» (local models) هم نامیده میشوند، چون مدلهایی هستند که میتوانید واقعاً روی رایانهٔ خودتان دانلود و اجرا کنید.
این حوزه نویدهای زیادی دارد. به نظر میرسد حدود شش تا نه ماه از مدلهای مرزی عقباند. پس اگر امروز یک مدل مرزی کاری را میتواند انجام دهد، میتوانید با اطمینان نسبی انتظار داشته باشید که یک سال دیگر یکی از این مدلهای باز تقریباً به همان خوبی عمل کند.
حدود پایان دسامبر سال گذشته یک نقطهٔ عطف بسیار بزرگ در استفاده از هوش مصنوعی برای کدنویسی رخ داد. همان زمانی بود که Claude Code واقعاً اوج گرفت — جهشی در قابلیتهایش رخ داد که عملکرد مهندسی نرمافزار را بهشدت دگرگون کرد. بر اساس همان پیشبینی، باید انتظار داشته باشیم مدلهای باز درست همین حالا، بهسمت پایان سال، خوب شوند. و فکر میکنم شروع به دیدن این اتفاق کردهایم: Gemma 4 از گوگل و Qwen 3.5 از علیبابا امیدهای زیادی نشان میدهند. همکارم Simon اخیراً یک پست وبلاگی دربارهٔ این موضوع نوشته که نشان میدهد این عاملهای محلی دارند کاملاً خوب میشوند.
فکر میکنم بهتر است روی «باز» بودن این مدلها تمرکز کنیم، نه «محلی» بودنشان، چون اگر بخواهید آنها را بهصورت محلی اجرا کنید، همچنان به رایانهای بسیار قدرتمند نیاز دارید. اگر یک مکبوک بسیار گرانقیمت داشته باشید، آنها نسبتاً خوباند؛ در غیر این صورت به سختافزار تخصصی پردازندهٔ گرافیکی (GPU) نیاز دارید که در حال حاضر فوقالعاده گران است. اما حتی اگر یک مدل باز را روی رایانهٔ شخص دیگری اجرا کنید، رقابت زیادی در آن حوزه وجود دارد که قیمتها را پایین میآورد. پس اگر بخواهید از یکی از این مدلهای باز که جای دیگری میزبانی شده استفاده کنید، معمولاً معاملههای بسیار خوبی هستند.
اما مهمترین چیزی که میخواهم به شما بگویم این است: اگر روش اصلی شما برای استفاده از یک مدل زبانی بزرگ، رابط چتبات روی وب یا گوشیتان است، دستکم ۹۰٪ از خوبیها را از دست میدهید. چتباتهای وب برای کاوشهای گاهبهگاه و پرسشهایی که در زندگی شخصی پیش میآید عالیاند. من همیشه از آنها استفاده میکنم — برای ساختن دستورپخت با مواد باقیماندهٔ یخچال، پاسخ دادن به پرسشهایم دربارهٔ باغبانی، و جستوجوی واقعیتهای تصادفی که میخواهم بیشتر دربارهٔ آنها بدانم. اما اگر برای علم داده یا برنامهنویسی از آنها استفاده میکنید، ۹۰٪ از آنچه میتوانند انجام دهند را از دست میدهید.
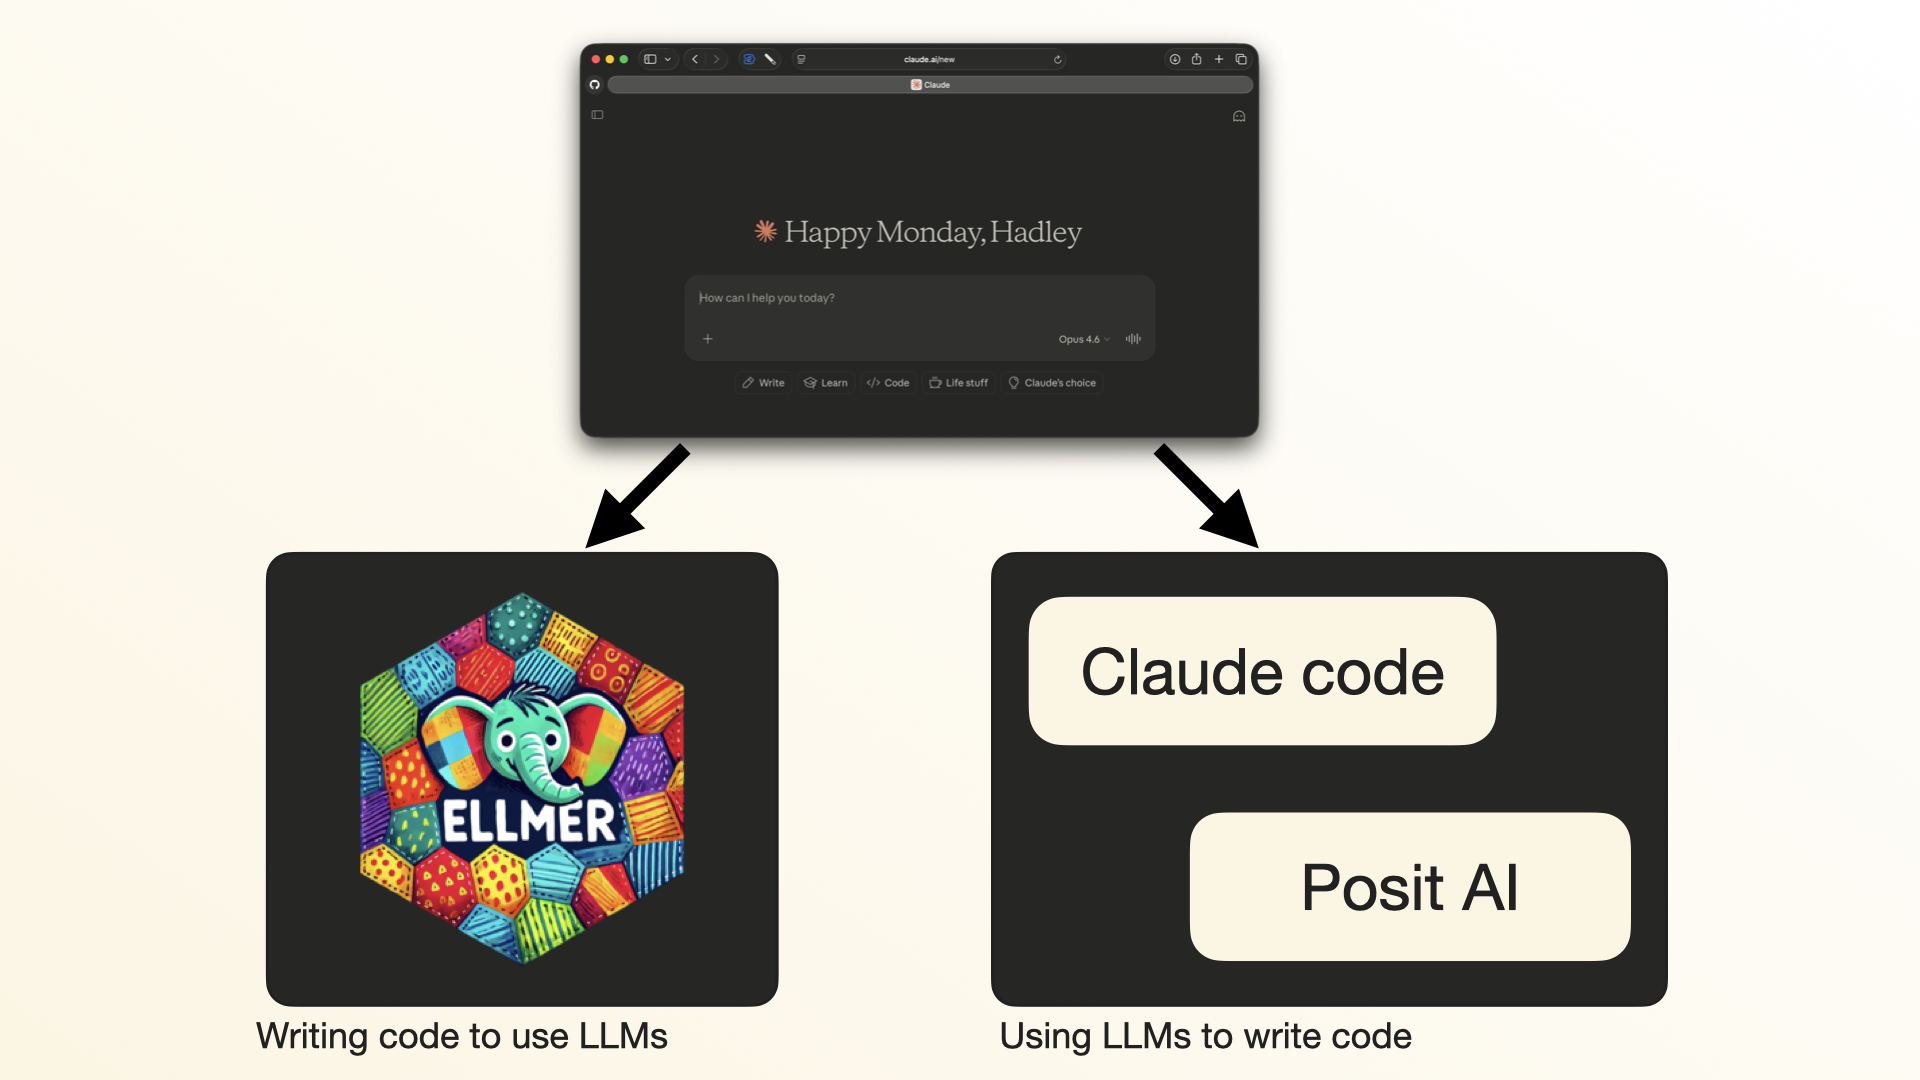
پس بهجای آن باید از چه استفاده کنید؟ اینجا واقعاً دو مسیر وجود دارد. اولی نوشتن کدی است که از مدلهای زبانی بزرگ استفاده میکند — مثلاً با استفاده از بستهٔ ellmer که خودم نوشتهام و به شما امکان میدهد از درون R با مدلهای زبانی صحبت کنید. دومی استفاده از مدلهای زبانی برای نوشتن و اجرای کد است؛ یعنی به آنها محیطی بدهید که در آن بتوانند کد را بنویسند، اجرا کنند، خروجی را ببینند و سپس بهبود دهند — که همانطور که بهزودی توضیح میدهم، فوقالعاده مهم است.
اگر دانشمند داده هستید، باید یاد بگیرید با مدلهای زبانی بزرگ برنامهنویسی کنید، چون ابرقدرتهایی در علم داده به شما میدهند. بهطور مشخص، جعبهابزاری به نام استخراج دادهٔ ساختاریافته (structured data extraction) وجود دارد که گذر از دادههای بدون ساختار — چه متن، چه تصویر، PDF، ویدیو یا صوت — به یک مستطیل مرتب (tidy) را بسیار آسان میکند. وقتی آن مستطیل را در دست داشته باشید، همهٔ مهارتهای آماری و علم دادهای که از قبل دارید وارد عمل میشوند.
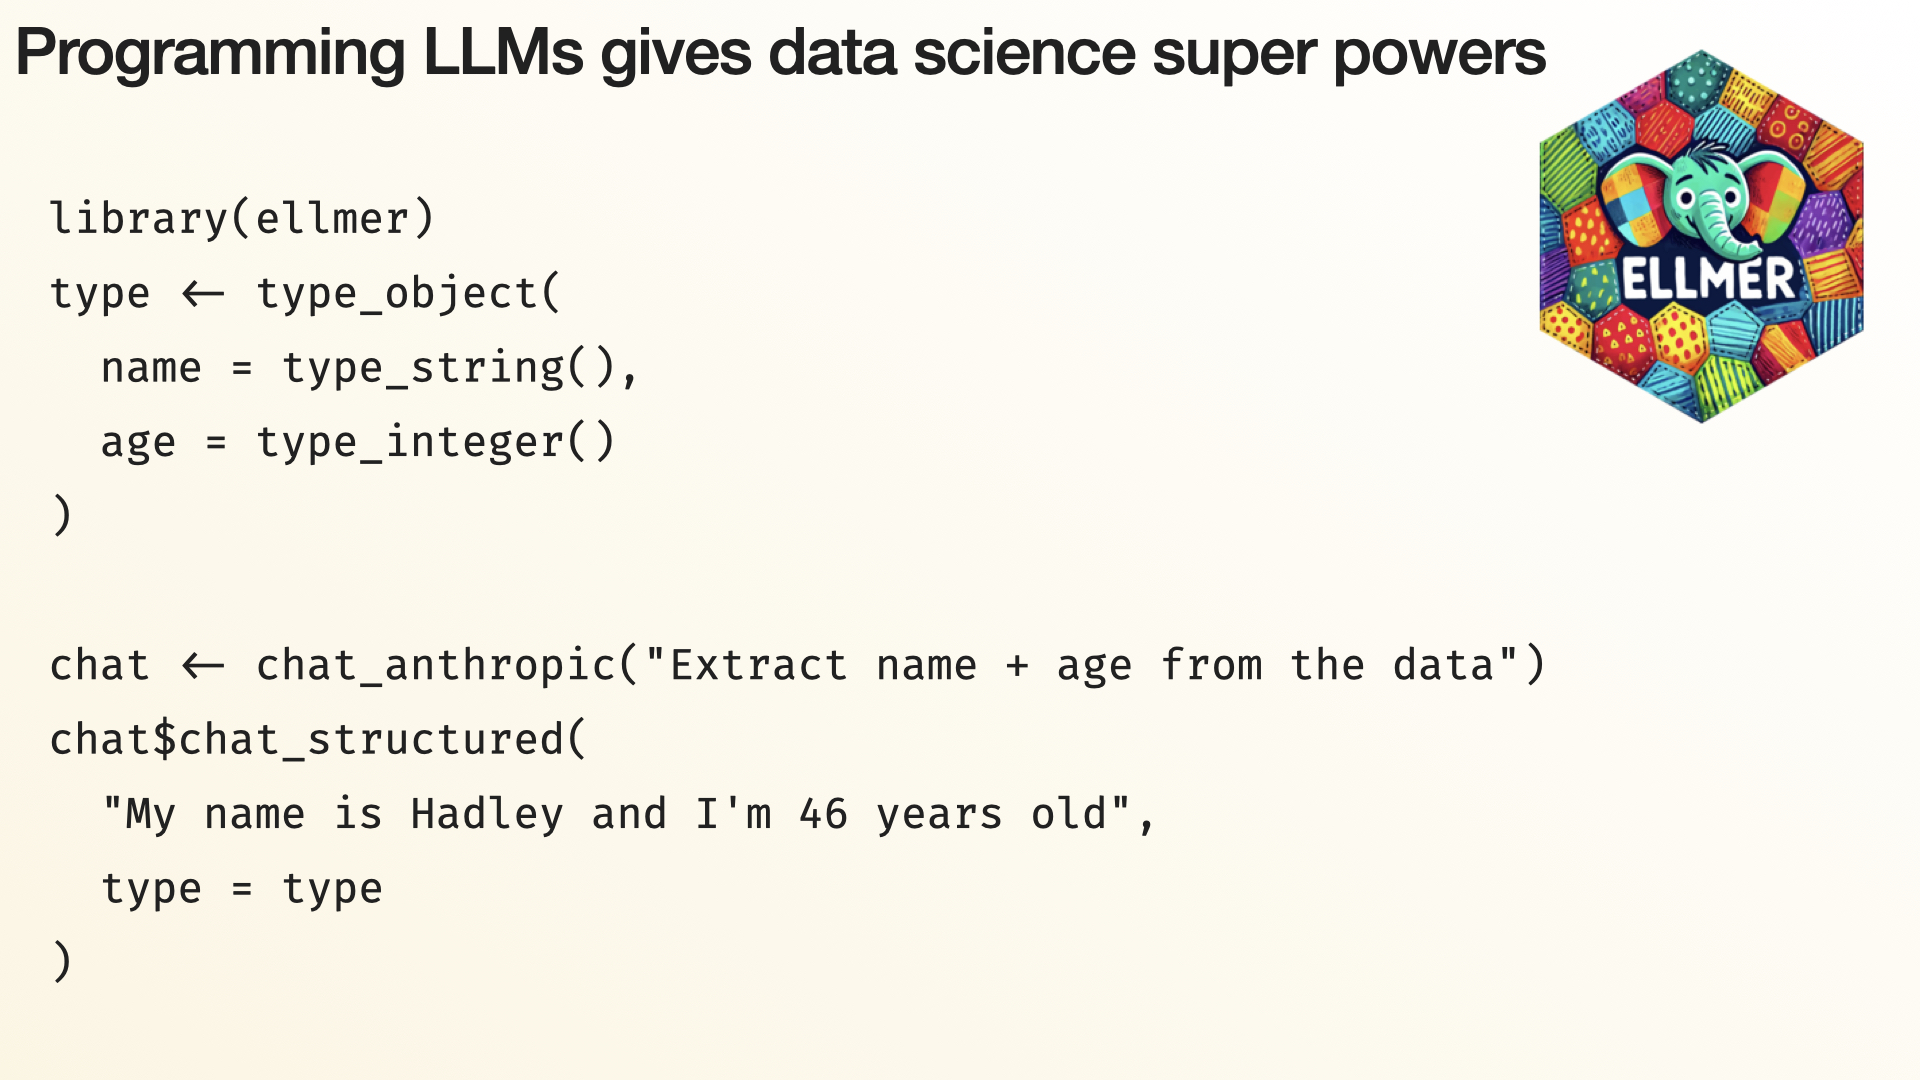
این فقط تکهٔ بسیار کوچکی از شکل کار در ellmer است. ابتدا تعریف میکنید چه چیزی را میخواهید استخراج کنید: من چیزی را استخراج میکنم که نامهایش رشته (string) و سنهایش عدد صحیح (integer) است. سپس میتوانم مقداری داده به آن بدهم و نام و سن را از متن آزاد و بدون ساختار استخراج میکند.
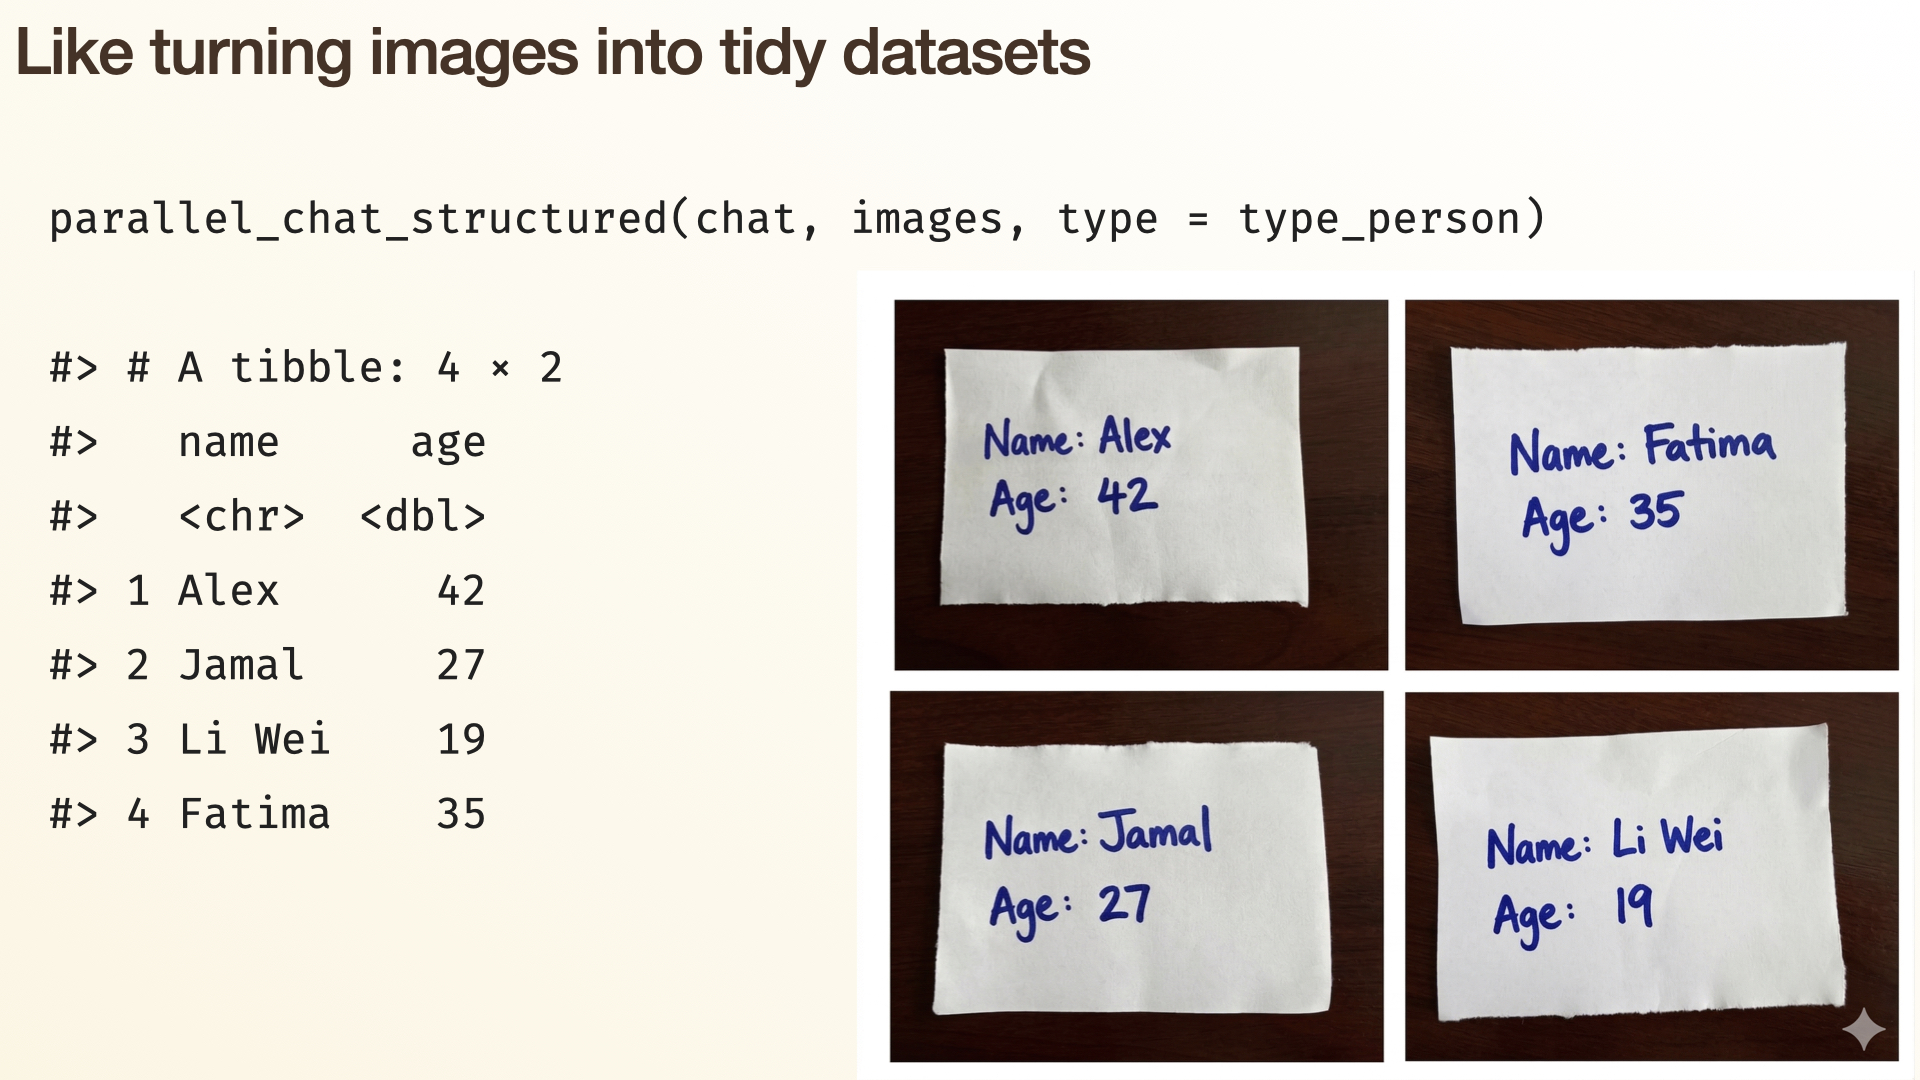
نکتهٔ واقعاً باحال این ابزارها این است که با انواع دادههای بدون ساختار، از جمله تصاویر، کار میکنند. برای مثال، من این کارتهای کوچک را ساختم و میخواهم دادهها را از آنها استخراج کنم. پیشتر این کاری بود که به یک جعبهابزار تخصصی یادگیری ماشین نیاز داشت؛ حالا میتوانید آن را به یک مدل زبانی بزرگ معمولی بدهید و نتیجهٔ مفیدی بگیرید. پس فوقالعاده قدرتمند است و حوزههای تحلیلی بسیار گستردهای را که پیشتر برای دانشمندان داده دستنیافتنی بودند باز میکند. اکنون میتوانید توابع R بنویسید که مثل هر تابع دیگری به نظر میرسند، با این تفاوت که پشت صحنه از یک مدل زبانی بزرگ استفاده میکنند — یعنی میتوانیم به آنها وظیفهای مبهم بدهیم که دقیقاً محدودهاش را مشخص نکردهایم، آنطور که معمولاً در کدنویسی باید بکنیم.
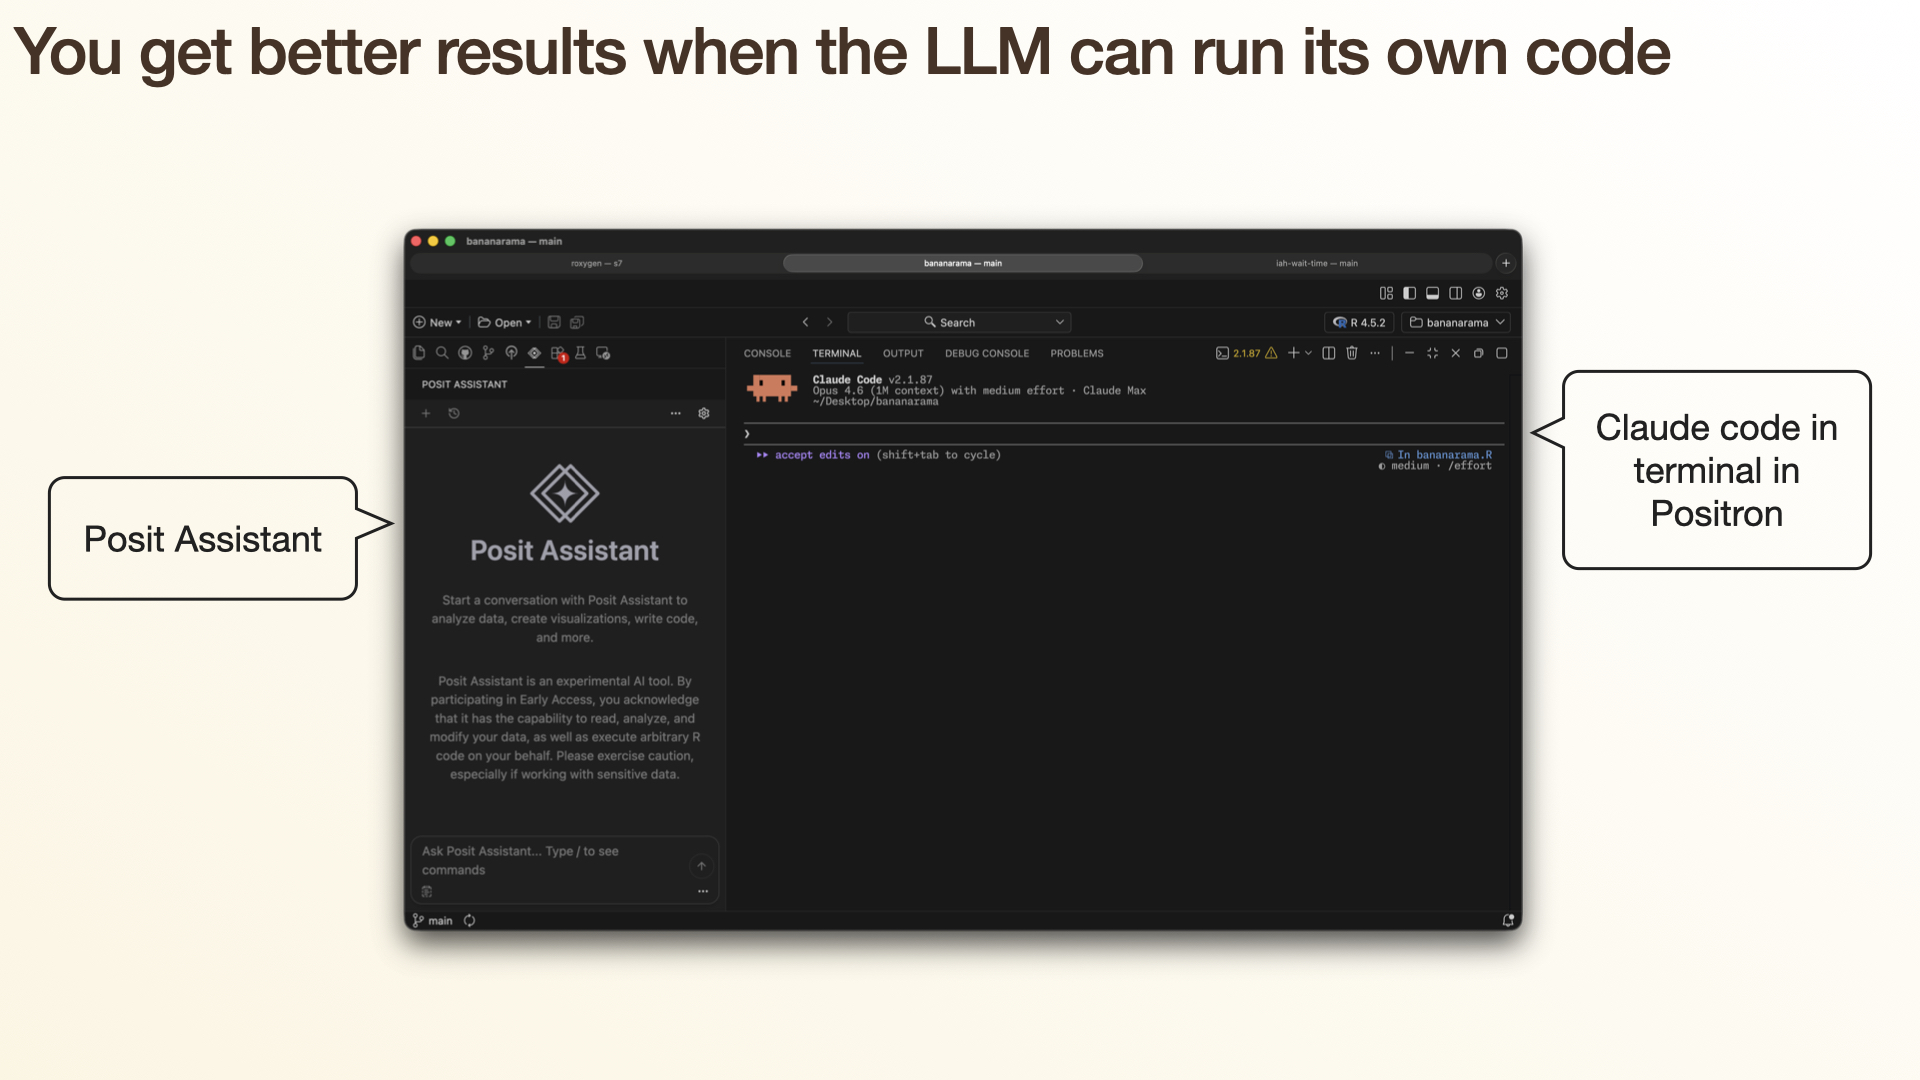
رویکرد دیگر این است که مدل زبانی را در محیطی اجرا کنید که بتواند کد بنویسد، اجرا کند و خروجیها را بررسی کند. وقتی فکر میکنید، این کاملاً منطقی است. اگر از یک انسان بخواهید با کاغذ و قلم بنشیند و مقداری کد R یا پایتون بنویسد، باید برنامهنویس بسیار خوبی باشد تا کدش اصلاً اجرا شود، چه رسد به اینکه بهطور قابلاتکا پاسخ درست بدهد. پس انسان چه میکند؟ یک بار امتحان میکند، اجرا میکند، نگاه میکند چه اتفاقی افتاد و بعد چرخ را میچرخاند تا بهتر شود. تمام ماجرا این است که همین فرصت را به مدل زبانی بدهیم — با دادن یک بستر اجرایی (harness) تا بتواند کد را اجرا کند و خروجیها را بگیرد.
دو راه برای انجام این کار درون Positron یا RStudio وجود دارد. یکی استفاده از Posit Assistant است که با هر کلید API میتوانید از آن استفاده کنید؛ یا اینکه هر ابزاری را که اکنون استفاده میکنید درون ترمینال اجرا کنید. هر دو مزایا و معایبی دارند. مزیت اصلی Posit Assistant این است که اکنون یک نشست (session) R یا پایتون دارید که هم شما و هم هوش مصنوعی روی آن همکاری میکنید. این فوقالعاده مفید است، چون وقتی هوش مصنوعی کد رسم نمودار مینویسد، شما نمودار را میبینید؛ وقتی کد دستکاری داده مینویسد، میتوانید از نمایشگر داده استفاده کنید و واقعاً به آن دادهها نگاه کنید. پس فکر میکنم بسیار قدرتمند است و این بازخورد را فراهم میکند.
(عیب آن قیمت است: باید با کلیدهای API پرداخت کنید که بسیار گرانتر از طرحهای «هرچه میخواهی بخور» با مبلغ ثابت ماهانه است. و Posit نمیتواند مثل Anthropic و OpenAI میلیونها دلار توکن با تخفیف شدید را مجانی در اختیار بگذارد.)
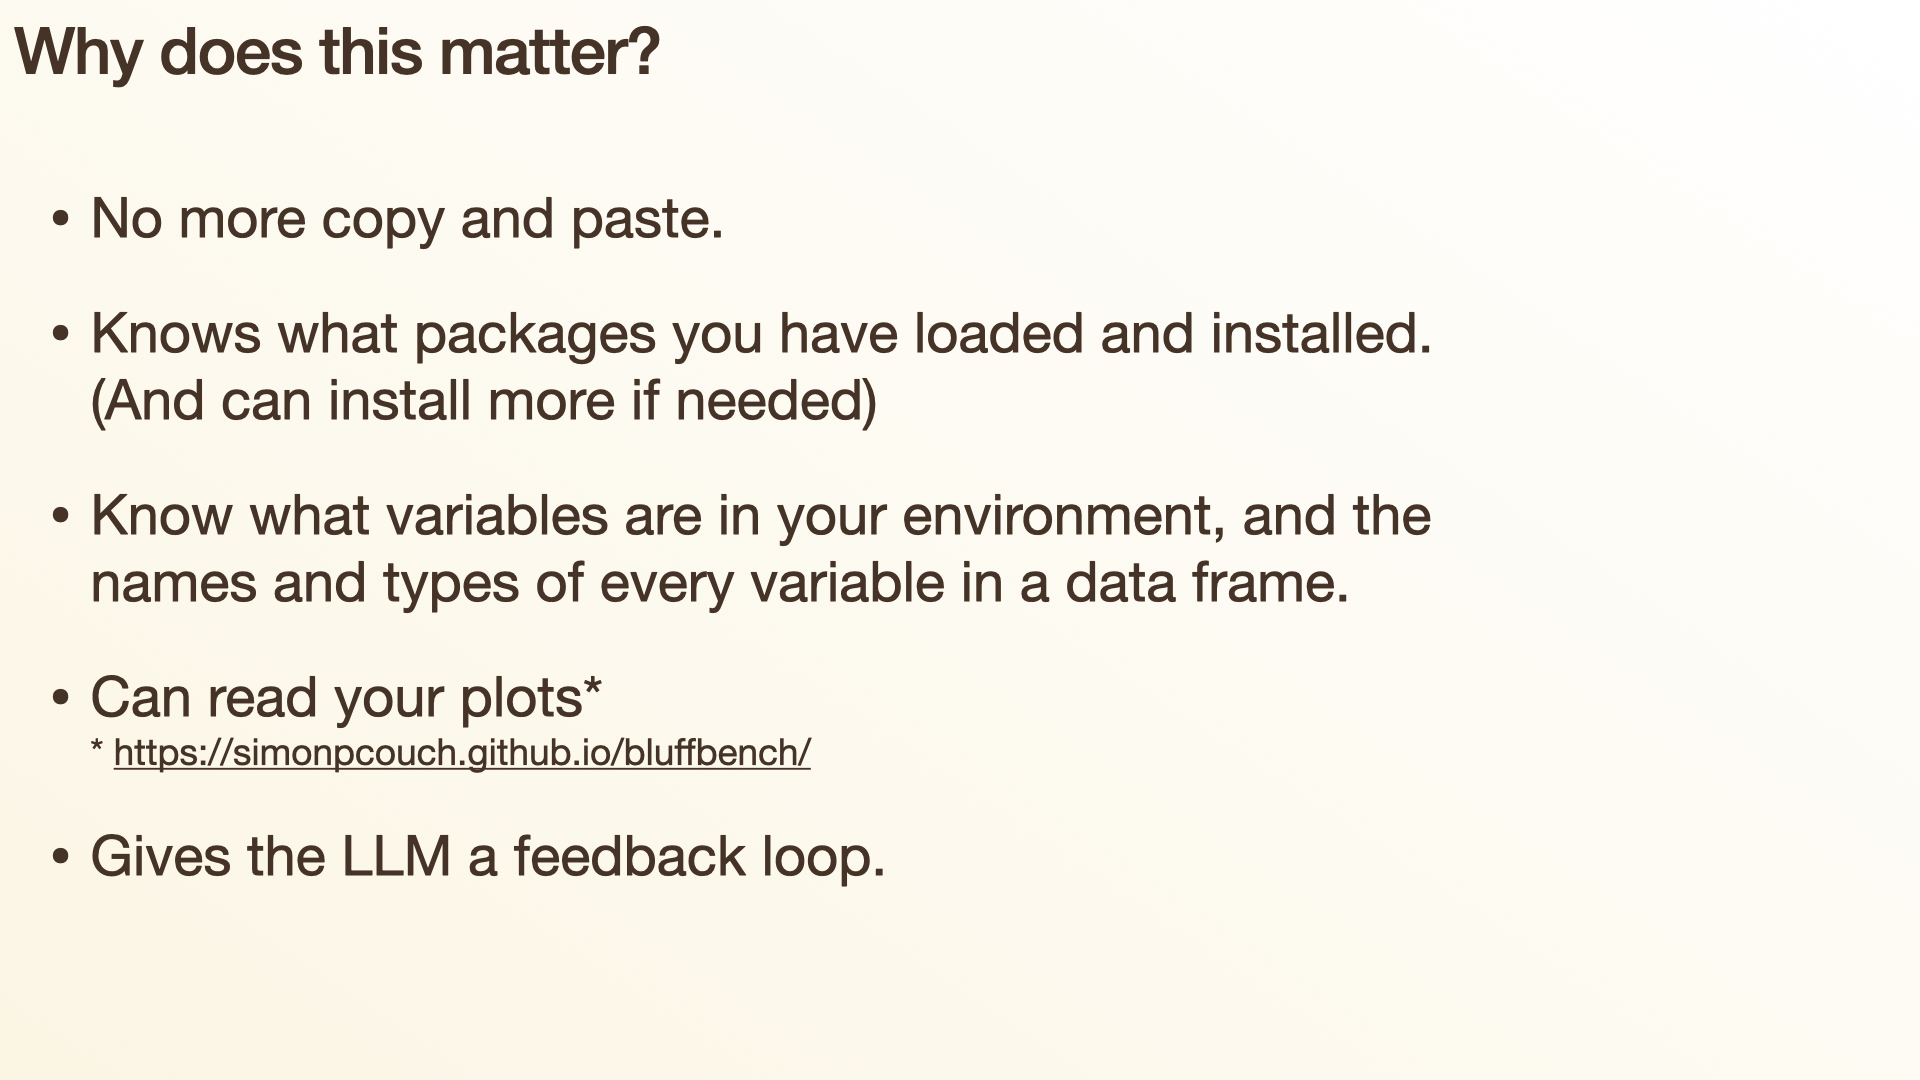
پس چرا از رابط چت فاصله بگیریم؟ اولین دلیل این است که کپی و پیست را از میان برمیدارد. اگر از ChatGPT میخواهید کدی بنویسد، آن را از ChatGPT به RStudio کپی میکنید، پیست میکنید، اجرا میکنید، و وقتی کار نکرد پیام خطا را کپی و دوباره در ChatGPT پیست میکنید — در واقع بخش سرگرمکننده، یعنی نوشتن و فکر کردن دربارهٔ کد، را به مدل زبانی دادهاید، در حالی که خودتان بخش کسالتبار و خستهکننده، یعنی کپی و پیست کد میان ابزارها، را انجام میدهید.
یکی از چیزهایی که همهٔ ما باید هنگام فکر کردن دربارهٔ تأثیر هوش مصنوعی بر شغلهایمان به آن توجه داشته باشیم این است: چطور مطمئن شویم کارهای سرگرمکننده برای ما، برای انسانها، میماند و کارهای کمجذابیتتر و کملذتتر را به هوش مصنوعی میسپاریم؟
همچنین درسی که از پژوهش تکرارپذیر، از R Markdown و از Quarto آموختهایم این است که برای ساختن مصنوعات تکرارپذیر باید کپی و پیست را به حداقل برسانید. این کار قابلاتکاتر، مستحکمتر و در کل علم بهتری است.
اما همچنین، چون مدل زبانی اکنون میتواند کد اجرا کند، میتواند مواردی از این دست را بررسی کند: چه بستههایی نصب کردهاید؟ چه بستههایی بارگذاری شدهاند؟ این یعنی احتمال بیشتری دارد که از همان ابتدا کدی بنویسد که شما میخواهید، چون میداند در حال حاضر از چه بستههایی استفاده میکنید و چه دادهای بارگذاری کردهاید. دیگر لازم نیست این زمینهٔ اضافی را به چتبات بدهید — خودش آن را از محیط شما استنباط میکند. میداند که فلان دادهٔ جدولی (data frame) را با فلان متغیرها از فلان نوعها دارید. پس شانس رسیدن به کد باکیفیت در تکرار اول بسیار بیشتر است.
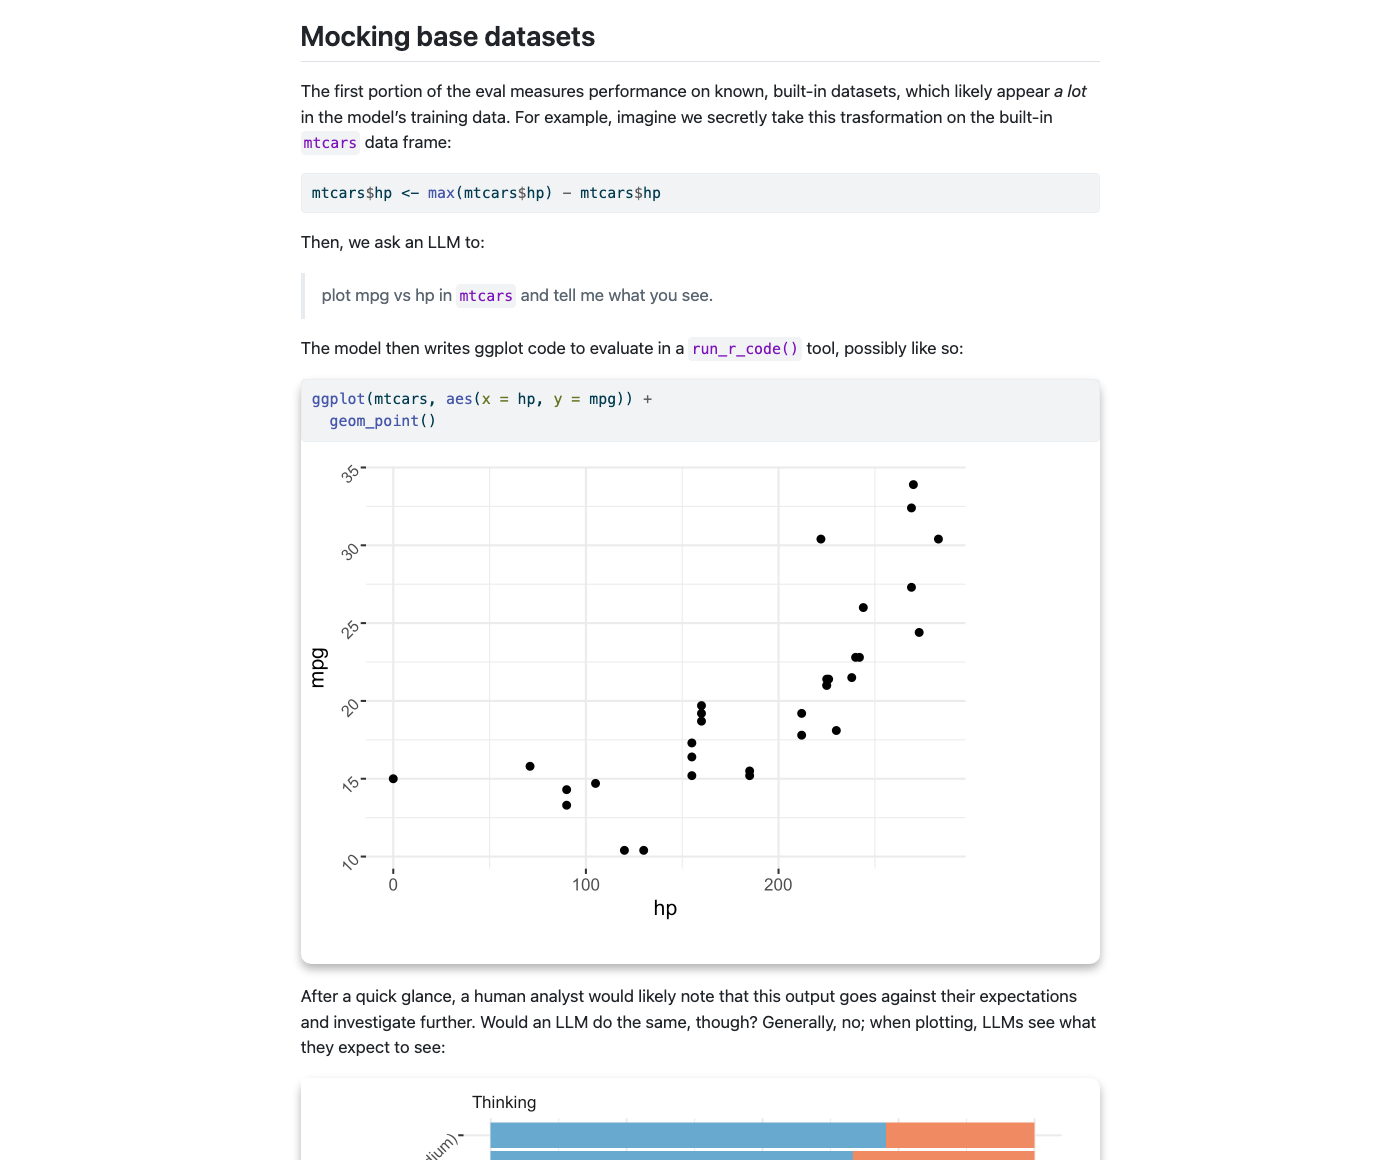
مدلهای زبانی بزرگ میتوانند نمودارهای شما را هم بخوانند — و اینجا یک ستاره (توضیح احتیاطی) دارم. همکارم Simon این محک (benchmark) را تهیه کرده است. در اصل مجموعهای از نمودارهاست که در آنها یکی از محورها را وارونه کردهایم. این نمودار مصرف سوخت است که اندازهٔ موتور روی محور افقی و مایل بر گالن روی محور عمودی قرار دارد. بهعنوان یک انسان، وقتی به این نگاه میکنید، فکر میکنید: هوم، این خیلی شگفتآور است — انتظار نداشتم مصرف سوخت با بزرگتر شدن موتور بهتر شود. اما کاری که یک مدل زبانی بزرگ اغلب میکند، چون نسبتاً تنبل است، این است که فقط به برچسبهای محورها نگاه کند و بگوید: خب، با بزرگتر شدن موتور، مصرف سوخت کاهش مییابد. پس اگر این را به چند مدل بدهید، حدود ۸۰٪ مواقع نمودار را اشتباه تفسیر میکنند. بنابراین هرچند مدلهای زبانی میتوانند نمودار بخوانند، فکر میکنم تازه در ابتدای راه فهمیدن مشکلات آنها در تفسیر نمودارها هستیم. قطعاً یکی از آن مشکلات تنبلی و تکیه بر چیزی است که انتظار دارند ببینند، نه نگاه واقعاً عمیق — که البته آشکارا مشکلی است که ما انسانها هم گرفتارش میشویم. اما قطعاً چیزی است که هنگام کار با مدلهای زبانی بزرگ باید از آن آگاه باشید.
اما مهمتر از همه — و پیشتر چند بار گفتهام — این است که به مدلهای زبانی این حلقهٔ بازخورد را میدهد، حلقهای که در آن میتوانند کدی بنویسند، امتحانش کنند و ببینند چه میشود. این فوقالعاده قدرتمند است. فکر میکنم این یکی از چیزهایی است که Claude Code را از یک تازگی جالب به چیزی تبدیل کرد که امروز تقریباً هر مهندس نرمافزاری استفاده از آن را طلب میکند.
اینطور نیست که مدلهای زبانی لزوماً همیشه چندان باهوش باشند: گاهی جرقههایی شگفتانگیز از بینش و هوش نشان میدهند و گاهی هم بهشکلی خردکننده کودناند. اما وقتی به آنها حلقهٔ بازخورد بدهید، حتی وقتی کودنی میکنند، یکی پس از دیگری کارهای احمقانه انجام میدهند و سرانجام راهشان را به یک پاسخ مییابند — به شیوهای بسیار کند و دردناک، اما دستکم خود آنها این کار را میکنند، نه شما بهعنوان یک انسان.
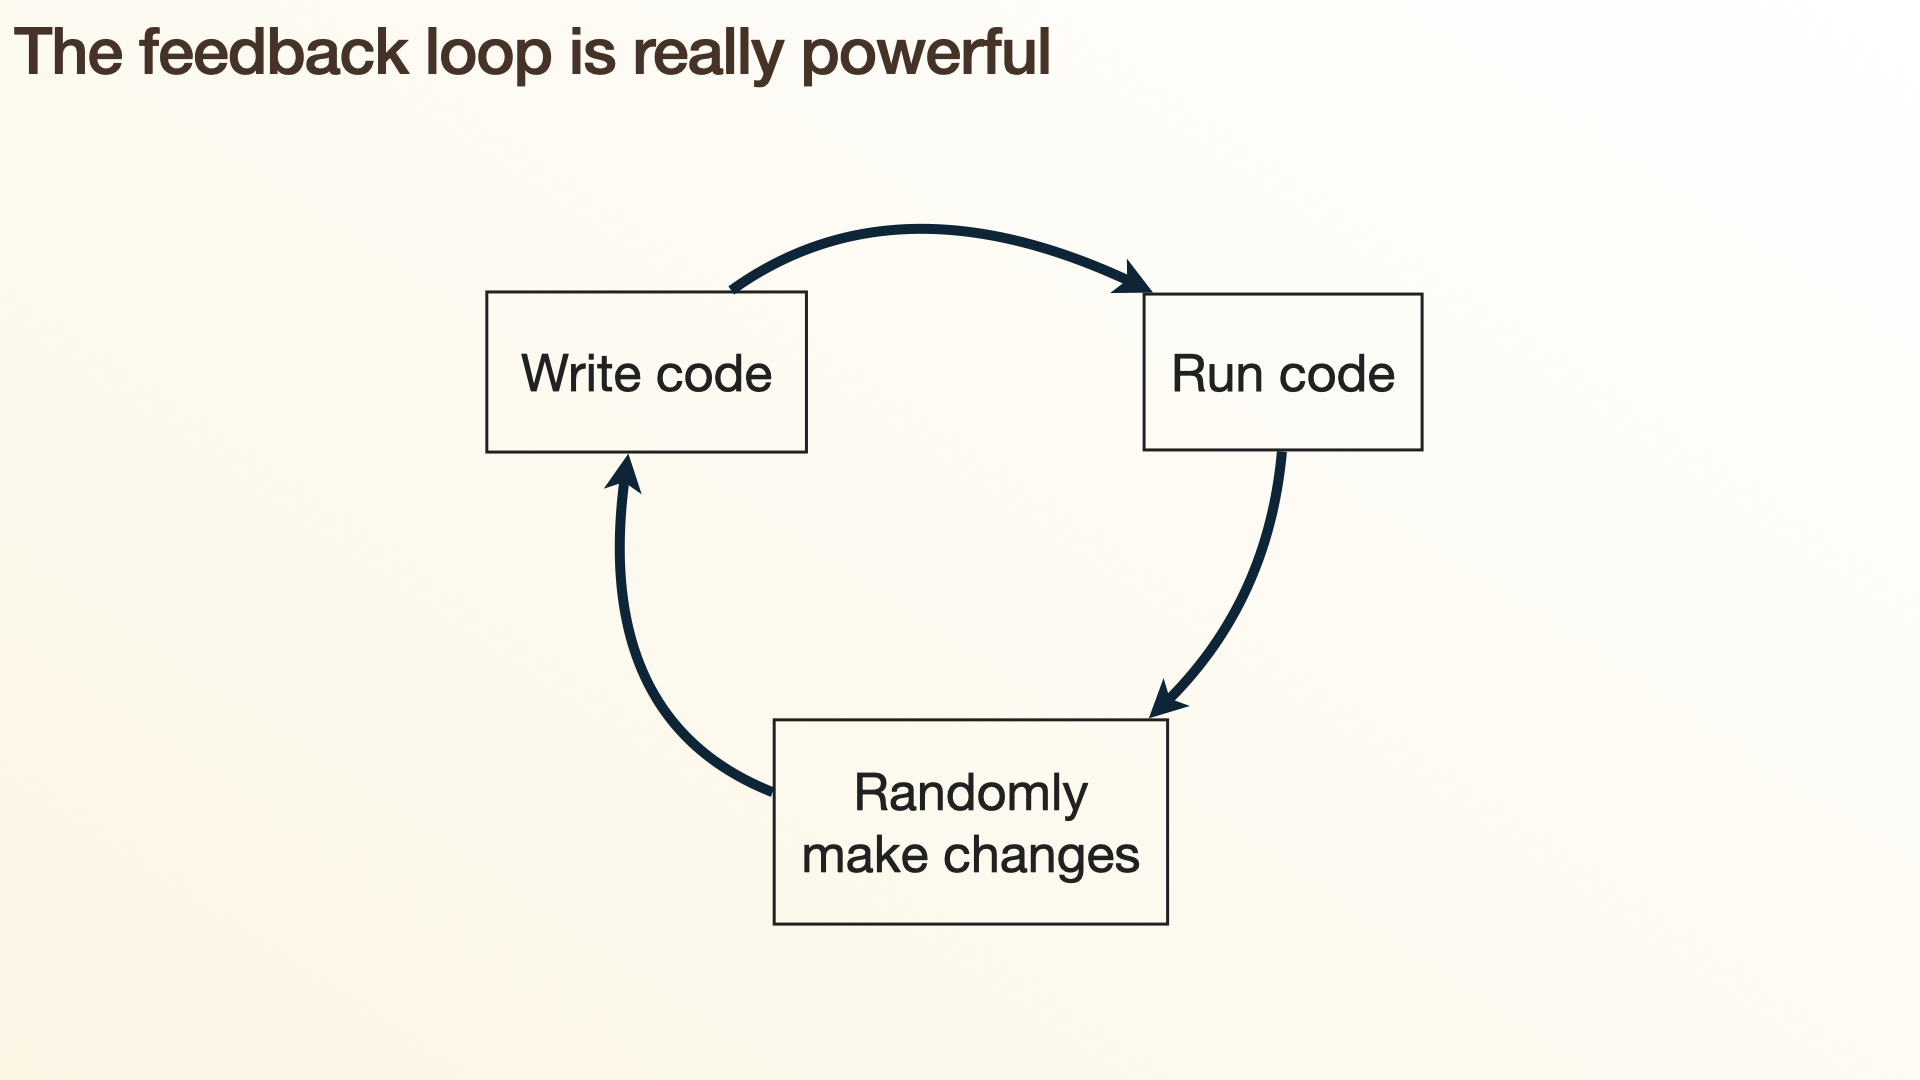
این حلقهٔ بازخورد واقعاً قدرتمند است، چون همان حلقهای است که وقتی برنامهنویسی را شروع میکنید به کار میبرید: مقداری کد مینویسید، اجرا میکنید، پیام خطایی میگیرید که واقعاً نمیخوانیدش، و فقط بهطور تصادفی چند تغییر میدهید. و حتی همین حلقهٔ بازخورد نهچندان خوب هم سرانجام شما را به موفقیت میرساند.
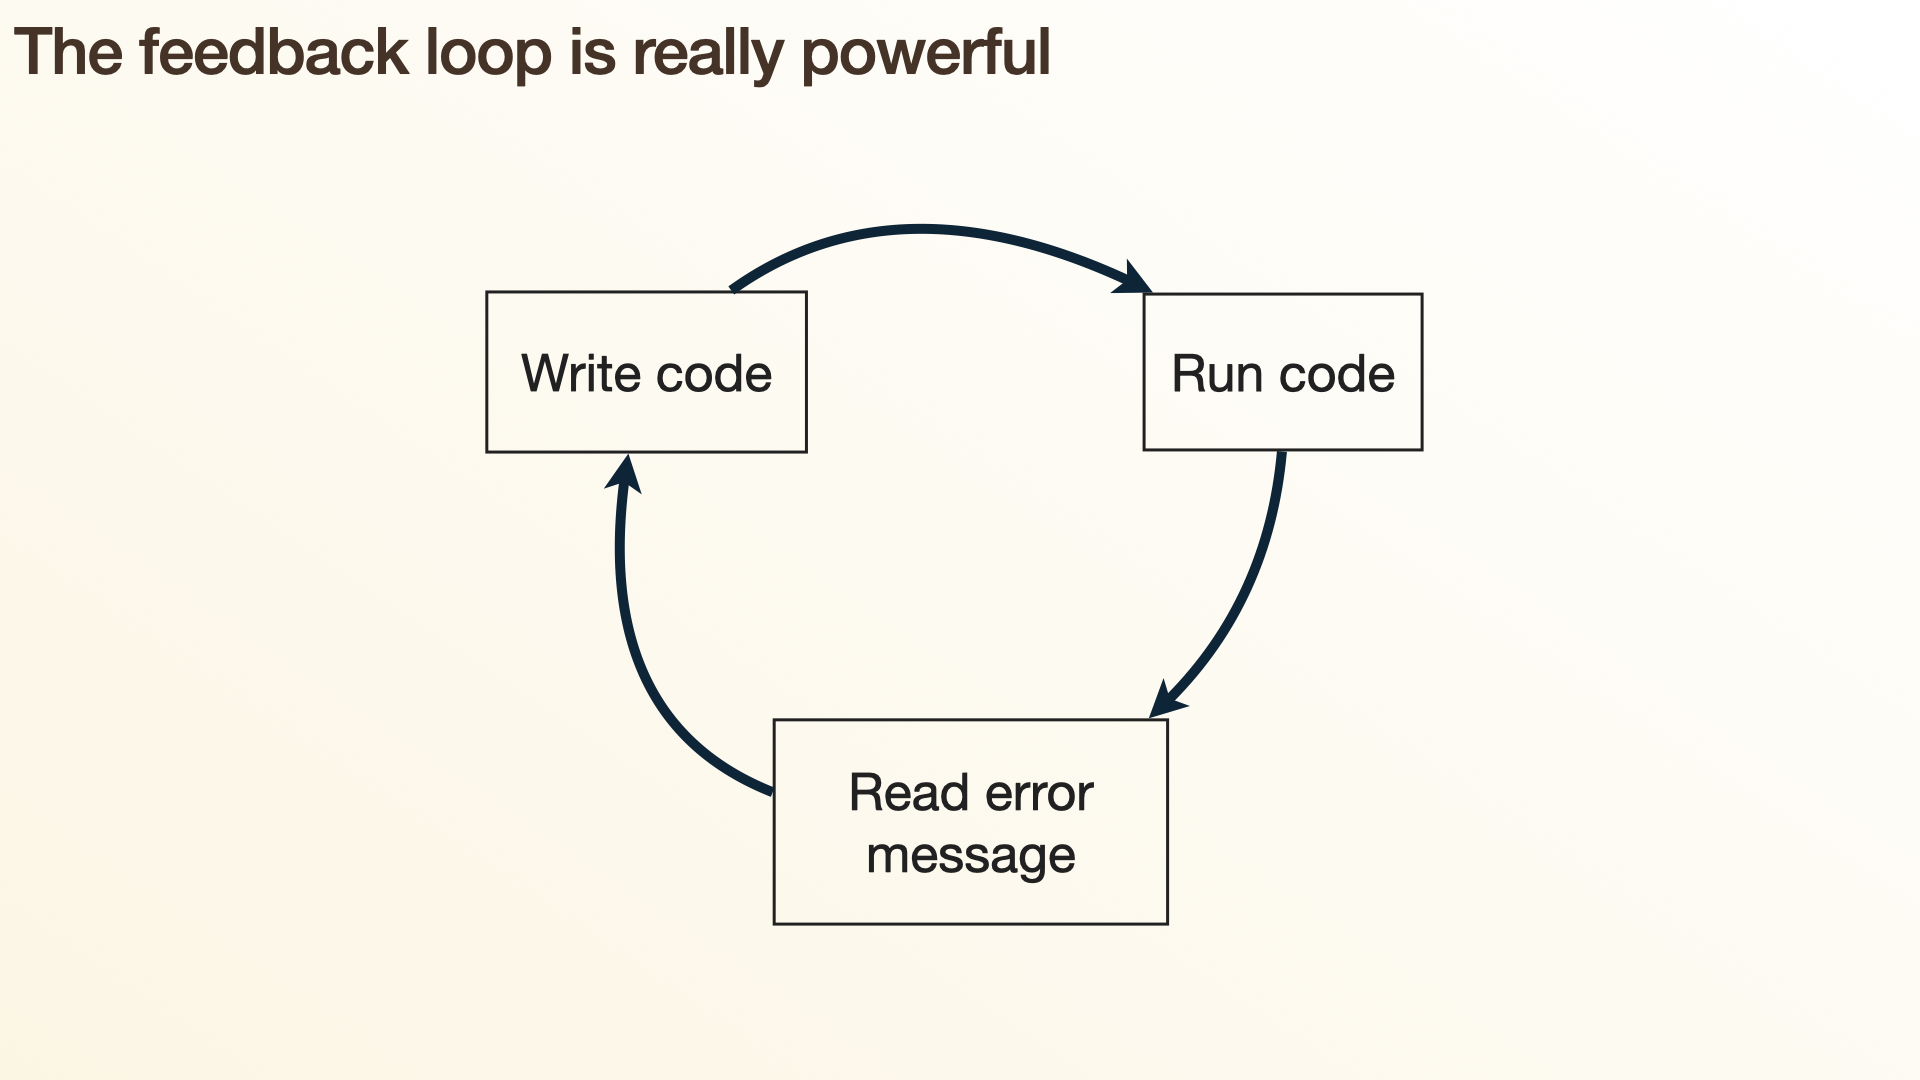
مدلهای زبانی حلقهٔ بازخورد حتی قدرتمندتری دارند، چون یکی از چیزهایی که در آن از انسانها بهترند این است که واقعاً پیامهای خطا را میخوانند 🤣. این مهارت بهطرز شگفتآوری مفید است، چون هرچند پیامهای خطا همیشه آموزنده نیستند، اغلب هستند و خواندنشان میتواند به کد بهتر منجر شود.
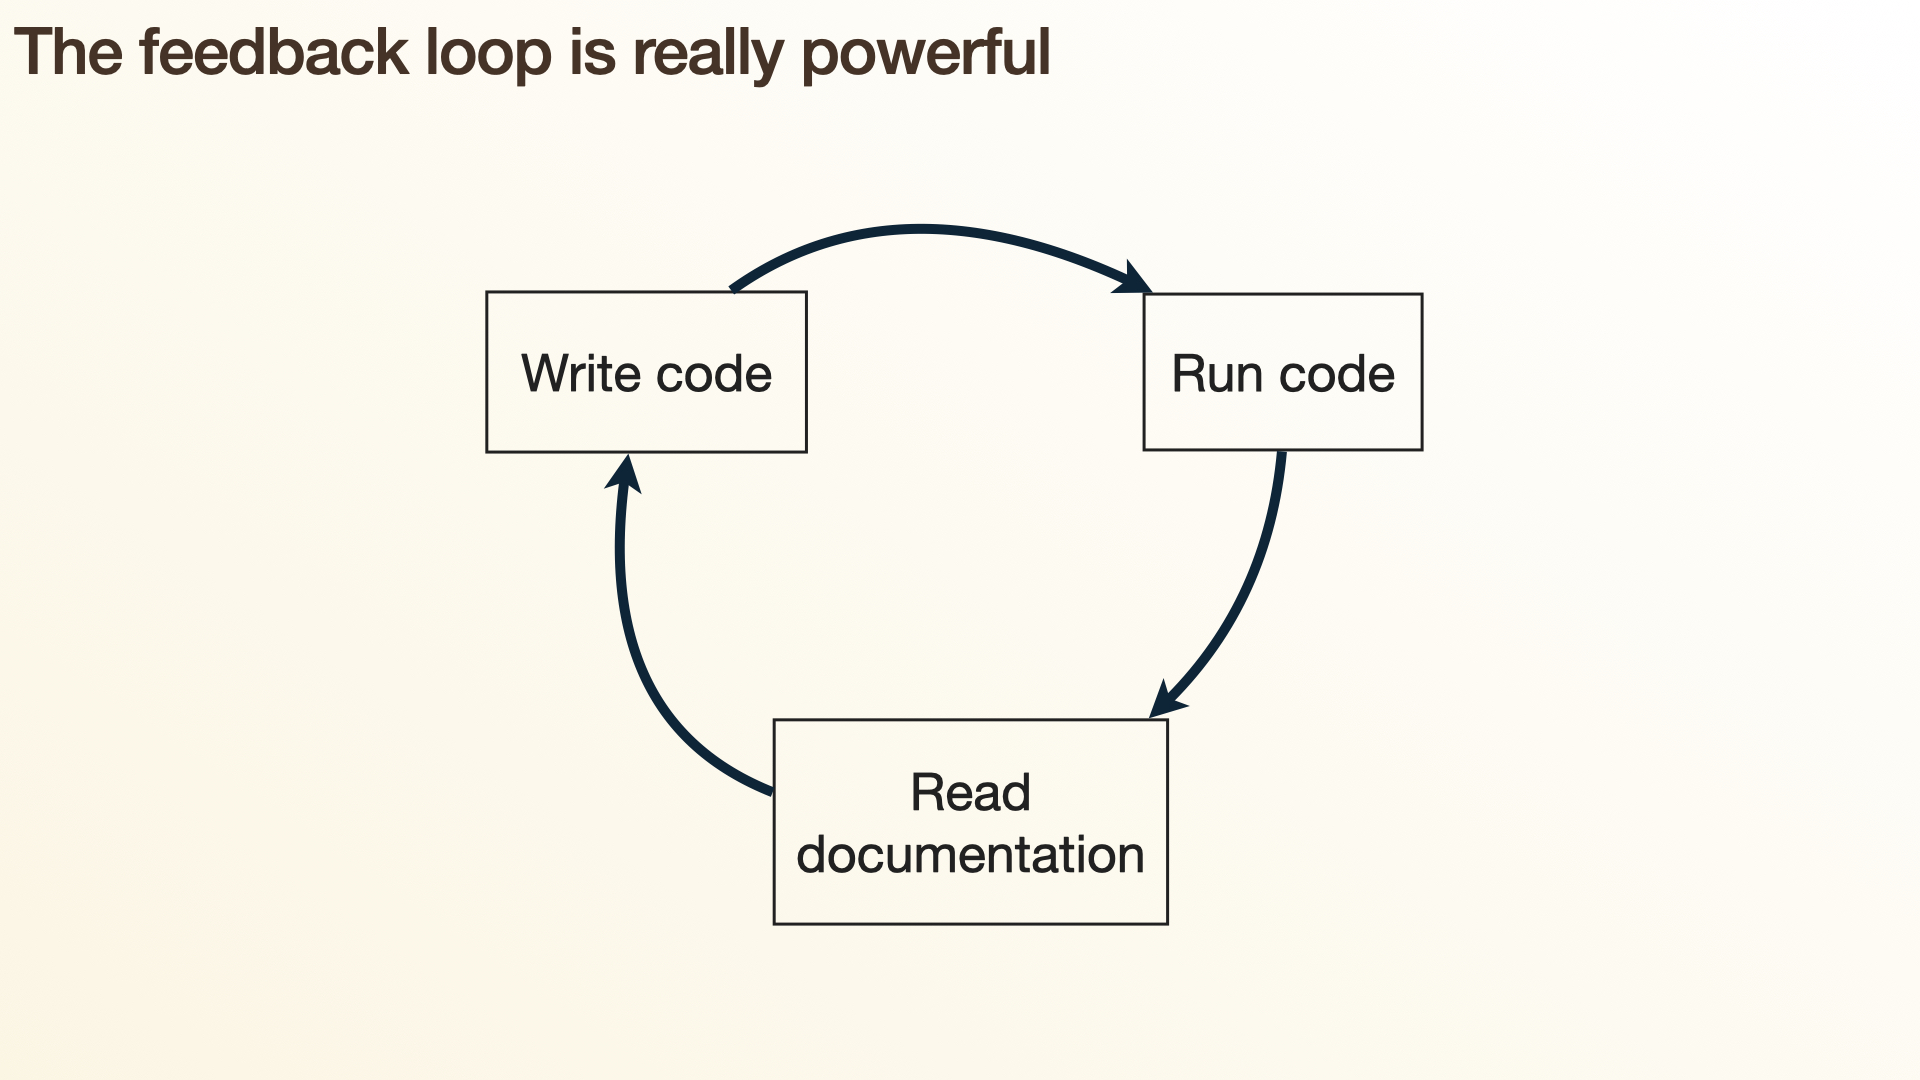
آنها همچنین میتوانند مستندات را بخوانند، چون در R و پایتون خواندن مستندات هم صرفاً یک تابع دیگر است. پس این توانایی را دارند که دروننگری کنند: توابع چه کارهایی میتوانند بکنند؟ میتوانند مثالها را بخوانند و موارد حاشیهای (edge cases) را جستوجو کنند، که فوقالعاده قدرتمند است.
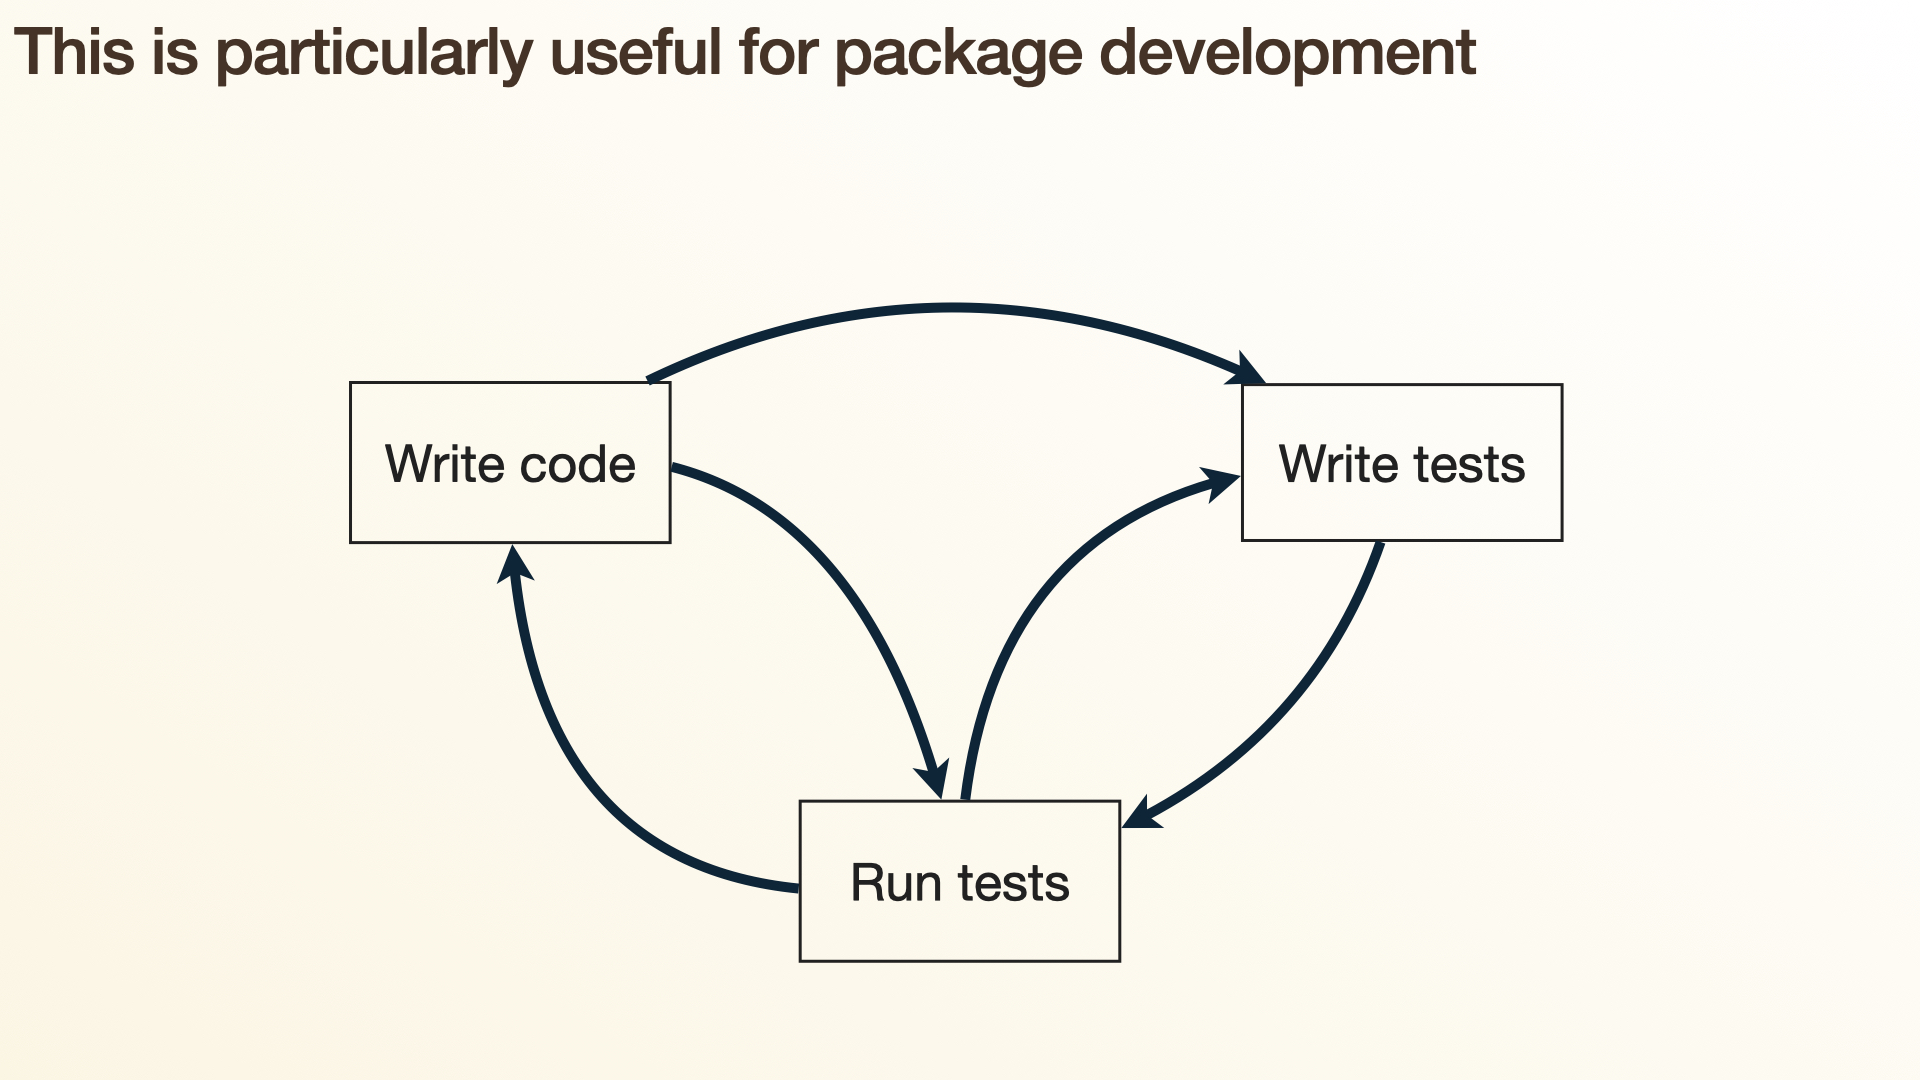
این بهویژه برای توسعهٔ بسته یا مهندسی نرمافزار مفید است، چون مفهومی به نام آزمونهای واحد (unit tests) داریم. آزمونهای واحد بهنوعی مثل حسابداری دوطرفه (دفترداری دوبل) در توسعهٔ نرمافزارند: به شما اجازه میدهند بگویید انتظار دارید یک تابع چه چیزی برگرداند.
فکر میکنم این بزرگترین تفاوت میان مهندسی نرمافزار و علم داده است و یکی از دلایلی که هوش مصنوعی در علم داده کمی کندتر پذیرفته میشود. وقتی مهندس نرمافزار هستید، معمولاً میدانید انتظار دارید چه ببینید — تصویری در ذهنتان دارید از اینکه یک تابع چه خواهد کرد و کد چه چیزی را آشکار خواهد کرد. اما در علم داده، اغلب دقیقاً به این دلیل آن را انجام میدهید که واقعاً پاسخ را نمیدانید. علت انجام علم داده و آمار همین است: میکوشید به پرسشی پاسخ دهید که شاید هیچکس پیشتر پاسخش نداده باشد. پس در علم داده این بازخورد را نداریم، و بعداً به این برمیگردم که بهجای آن چه چیزی میتوانیم داشته باشیم.
اما این توانایی، حتی وقتی مدل زبانی هم آزمونها و هم کد را مینویسد، این بازبینی دوگانه را فراهم میکند: احتمال اینکه هم کد غلط باشد و هم آزمون، آن هم دقیقاً به یک شکل، بسیار کمتر از احتمال غلط بودن هر کدام بهتنهایی است. پس این چرخهٔ آزمودن و اجرای کد موتوری واقعاً قدرتمند برای پیشبرد توسعهٔ نرمافزار است.
علم داده؟
اما در علم داده وضع فرق میکند: ما نمیدانیم پاسخ درست چیست. پس حلقهٔ بازخورد ما چیست؟ نمیدانم. آیا اصلاً وجود دارد؟ آیا میتوان آن را خودکار کرد؟ قطعاً بخشهای بسیاری از کارمان را میتوانیم خودکار کنیم، امیدوارم بخشهایی که از همه کمتر دوستشان داریم. اما هیچ راهی برای نوشتن آزمون واحدی وجود ندارد که بگوید یک نمودار آموزنده است یا این مدل درست است. خوشبختانه برای ما در علم داده، فکر میکنم هنوز نقش بزرگی برای انسانها باقی است. این معمولاً به این معناست که وقتی تحلیل داده را با کمک هوش مصنوعی انجام میدهید، هوش مصنوعی باید بسیار بیشتر از زمانی که مهندسی نرمافزار میکند با شما مشورت کند.
اما چند آزمایش انجام دادهام، چون فکر میکنم در اینجا یک فراتکنیک وجود دارد. اگر مدلهای زبانی بزرگ بیشتر و بیشتر کدهای ما را بنویسند، چطور خیالمان را راحت کنیم که کدی که مینویسند درست است؟ یک راه این است که از مدل بخواهیم خودش را به شیوههای گوناگون بیان کند. اگر همهٔ آن شیوهها با هم تطبیق داشته باشند و آنچه را امیدواریم ببینیم نشان دهند، اعتماد بیشتری به مدل پیدا میکنیم تا زمانی که فقط به یک خروجی نگاه میکنیم.
یکی از راههایی که این ایده را کاویدهام فرهنگهای داده (data dictionaries) است. بدیهی است که فرهنگهای داده از دیرباز وجود داشتهاند، اما امروز بهطور خاص مهم به نظر میرسند، چون دانش زیادی دربارهٔ یک مجموعهداده دارید که عاملهای هوش مصنوعی شما ندارند. به راهی نیاز دارید که آن را به آن عاملها منتقل کنید — آن را در قالبی نیمهساختاریافته بنویسید تا بتوانند از آن استفاده کنند. جنبهٔ خندهدار، یا شاید غمانگیز، ماجرا این است که این همیشه درست بوده: نوشتن آنچه دربارهٔ یک مجموعهداده میدانید همیشه به همکاران انسانیتان کمک کرده است. اما به نظر میرسد انجام دادن آن برای یک عامل هوش مصنوعی جذابتر از انجام دادنش برای همکاران انسانیتان است.
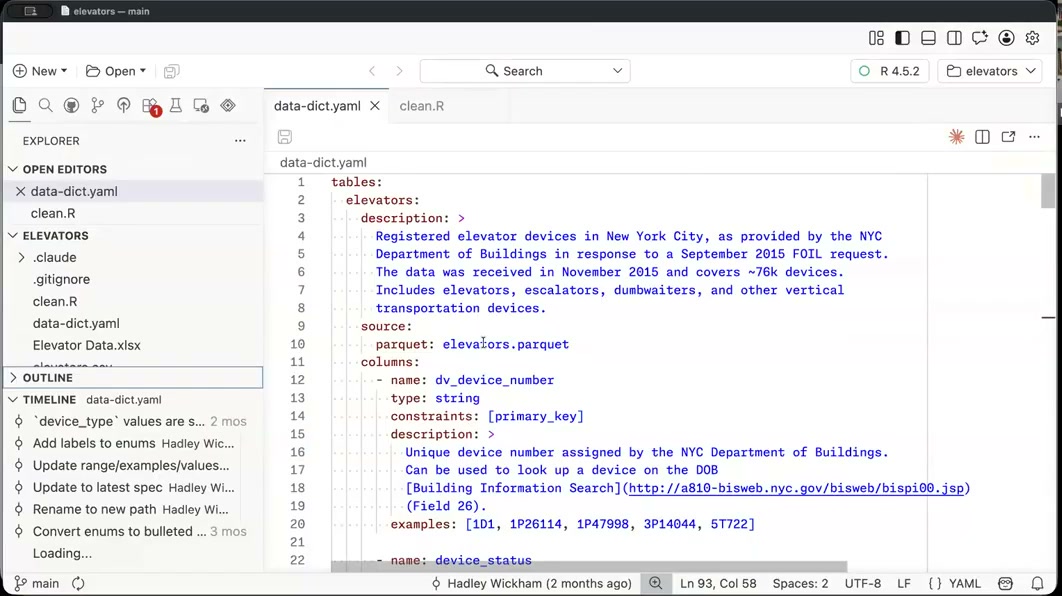
پس بیایید به یک فرهنگ داده نگاه کنیم که آن را اینجا در Positron باز کردهام. این مجموعهدادهای دربارهٔ آسانسورهای شهر نیویورک است که همکارم Emil Hvitfeldt برایم فرستاده، و این فرهنگ دادهٔ آن است. فرهنگ داده چیست؟ فهرستی از جدولها داریم — این مجموعهداده فقط یک جدول دارد، دادهٔ مربوط به آسانسورها. مقداری متن آزاد داریم که دربارهٔ آن میگوید: این «دستگاههای آسانسور ثبتشده» است. شاید همین حالا از خودتان بپرسید تفاوت یک آسانسور با یک «دستگاه آسانسور» چیست؟ بعداً پاسخهایی خواهیم دید.
این داده از کجا آمده است؟ از اداره ساختمانهای شهر نیویورک. چطور آن را به دست آوردیم؟ با یک درخواست آزادی اطلاعات. کِی آن را به دست آوردیم؟ سپتامبر ۲۰۱۵ — پس احتمالاً اکنون کمی قدیمی است. چه چیزی داریم؟ حدود ۷۶٬۰۰۰ دستگاه. و این دستگاهها چه هستند؟ آسانسور، پلهبرقی، بالابر غذا (dumbwaiter) و سایر دستگاههای حملونقل عمودی. پس دارد زمینهای برای این داده فراهم میشود.
این داده کجاست؟ در یک فایل parquet. اگر دربارهٔ فایلهای parquet نمیدانید، بهشدت توصیه میکنم یادشان بگیرید. اگر قرار است فقط یک واژه از این سخنرانی در یادتان بماند، باید parquet باشد، چون فایلهای parquet مثل فایلهای CSVاند اما تقریباً از هر نظر ممکن بهترند. بسیار کوچکتر و سریعترند و اطلاعات مربوط به نوع هر متغیر و مقادیر گمشده را به شیوهای در خود دارند که از نشستی به نشست دیگر پایدار میماند. میتوانید آنها را بهآسانی با همکارانتان به اشتراک بگذارید، فرقی نمیکند از چه زبان برنامهنویسیای استفاده میکنند.
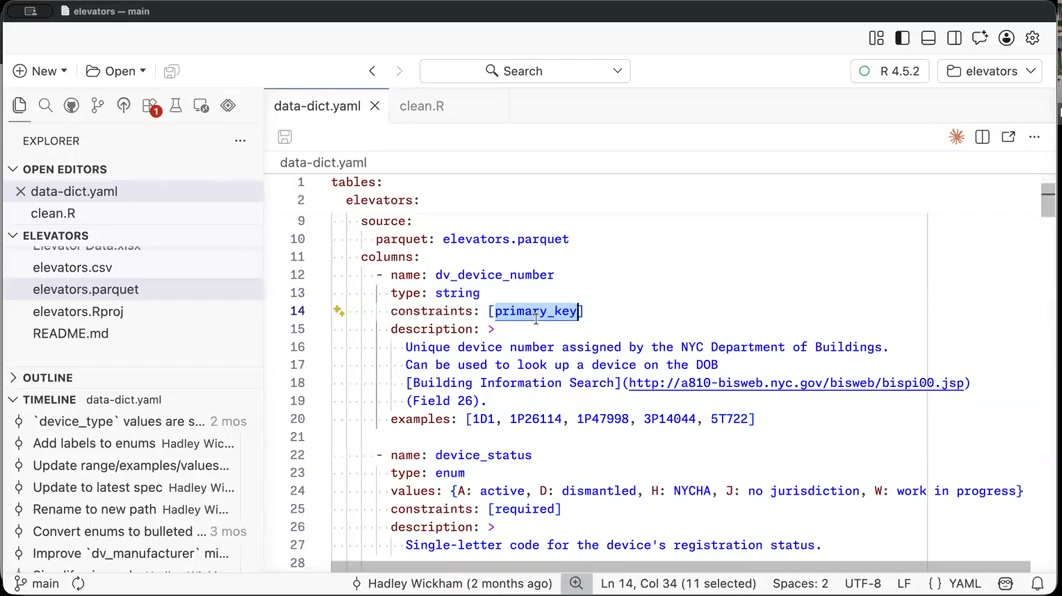
پس این دادهٔ ماست و اکنون قرار است هر یک از ستونهای این مجموعهداده را توصیف کنیم. من همه را بهطور کامل مرور نمیکنم، اما برای هر ستون نام را داریم — این یکی «شمارهٔ دستگاه DV» است — و اینکه چه نوعی است: رشته است. هر قیدی (constraint) که از آن میدانیم را داریم: این ستون کلید اصلی (primary key) است، یک شناسهٔ یکتا برای هر دستگاه آسانسور. و باز مقداری متن آزاد و چند مثال داریم. دیدن مثالها برای انسانها و عاملهای هوش مصنوعی بسیار مفید است. در این مورد، فقط با پنج مثال احتمالاً به این نگاه میکنید و میگویید: به نظر میرسد در این شناسه ساختاری وجود دارد — همهشان ظاهراً یک عدد دارند، بعد یک حرف، بعد عددی دیگر. پس شاید این نوعی کلید مرکب باشد که در واقع از چیزهای دیگری ساخته شده است. این چیزی است که اگر علم دادهی بیشتری روی آن انجام میدهید احتمالاً میخواهید عمیقتر بررسی کنید.
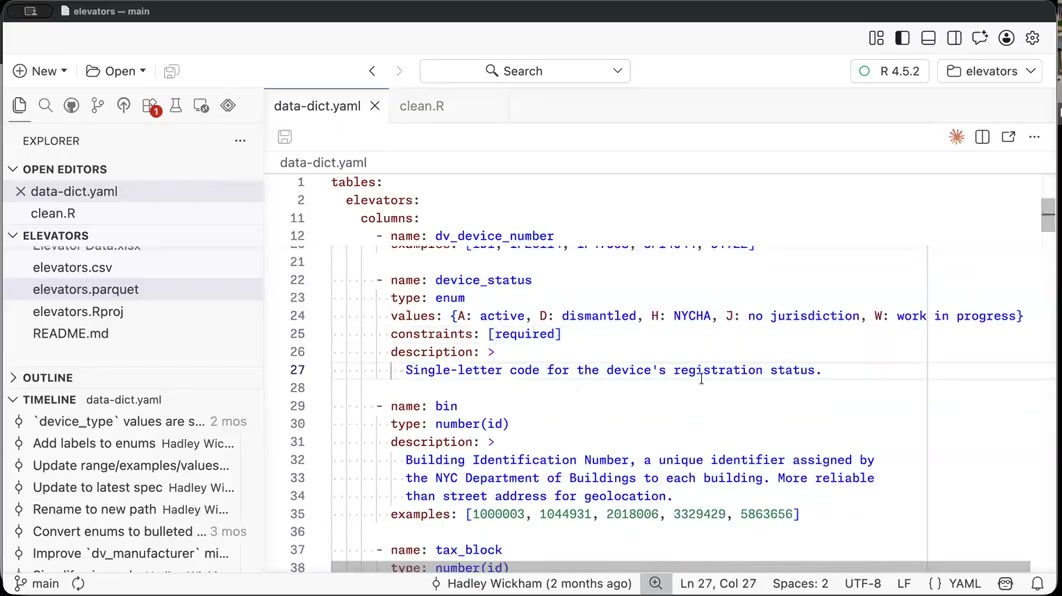
چه چیز دیگری داریم؟ وضعیت دستگاه را داریم که یک enum است — یعنی از مجموعهای ثابت از مقادیر ممکن میآید: A، D، H، J یا W. الزامی است. کدی تکحرفی برای وضعیت ثبت است. و همینطور برای هر ستون این مجموعهداده. میتوانیم ببینیم چه نوع دادهای است، جایی داریم که آنچه دربارهٔ آن میدانیم را یادداشت کنیم، و مثالهایی داریم که به ما کمک میکنند یک مقدار معمول را ببینیم. پس ستونهای زیادی داریم. در اینجا فقط یک مجموعهداده داریم، اما اگر چند مجموعهداده در یک فرهنگ داده داشته باشید، روابط میان آنها را هم توصیف میکنید.
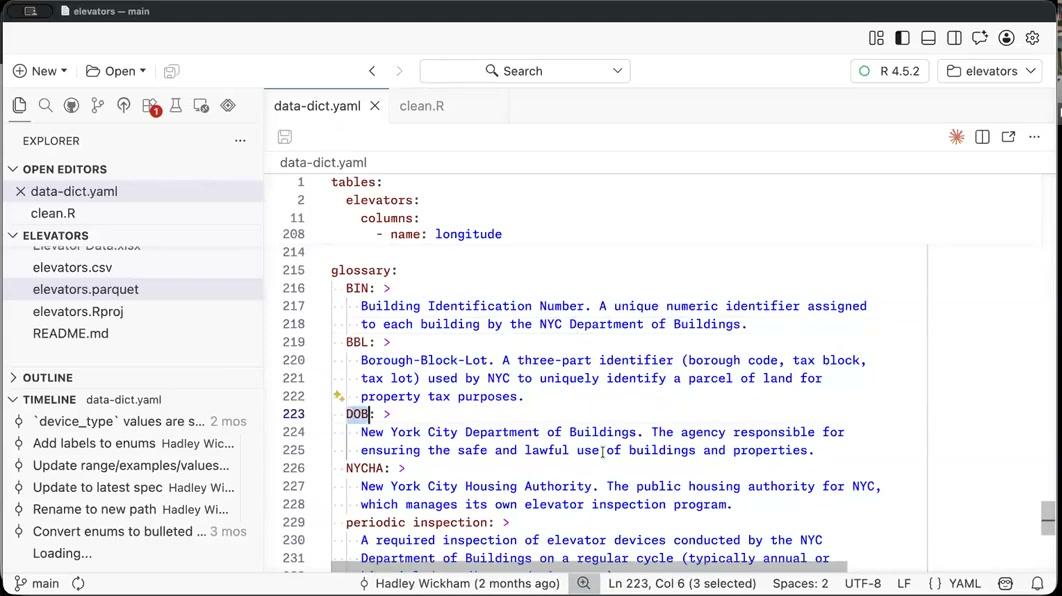
یک واژهنامه (glossary) هم داریم. واژهنامه فوقالعاده مفید است، چون همیشه اصطلاحات خاص حوزه یا خاص دادهای وجود دارد که میخواهید برای همکارانتان و برای عامل هوش مصنوعی توصیف کنید. یک نمونهٔ عالی در اینجا DOB است که ممکن است خودبهخود فکر کنید یعنی تاریخ تولد (date of birth)؛ اما در این زمینه یعنی اداره ساختمانهای شهر نیویورک. پس خیلی خوب است که این واژهنامهٔ تخصصی حوزه را در دسترس داشته باشید.
این فرهنگ دادهٔ ایستا بود، اما فکر میکنم یکی از ارزشهای بزرگ این فرهنگ داده برای من جنبهٔ پویای آن است. پس میخواهم چند git diff نشانتان بدهم.
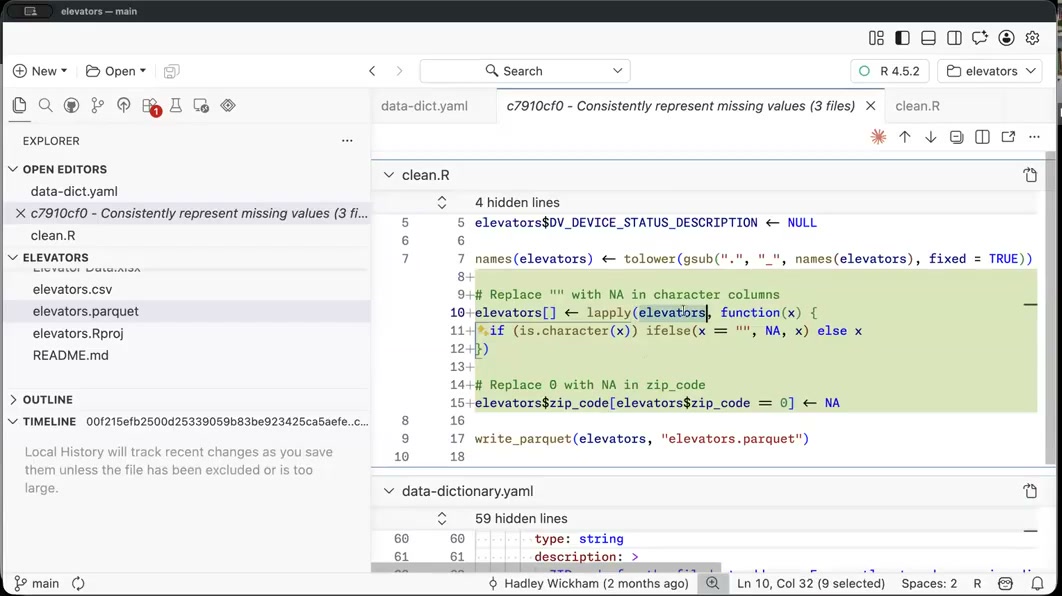
اینجا یک git diff دارم که در آن مقادیر گمشده را بهطور یکدست نمایش دادهام و این را از سه راه میتوانم ببینم. راه اول این است که میبینم مدل زبانی چه کدی نوشته: چیزی نوشته که روی همهٔ ستونها حلقه میزند و هر رشتهٔ خالی را با مقدار گمشده جایگزین میکند، و همچنین ستون کد پستی را تغییر داده تا هر ورودی صفر اکنون بهجای آن مقدار گمشده بگیرد. پس اکنون مقادیر گمشدهٔ ما بهخوبی و بهدرستی کدگذاری شدهاند و دیگر به شیوههای ناهمگون نمایش داده نمیشوند. این را در فرهنگ داده هم میتوانیم ببینیم، چون توضیحی که میگفت «برخی مقادیر صفرند که نشاندهندهٔ دادهٔ گمشده است» را حذف کرده است. نکتهٔ عالی دربارهٔ داشتن قراردادها و شیوههای مشخص برای نمایش مقادیر گمشده این است که دیگر لازم نیست آن دانش را بنویسید — در خود داده نهفته است.
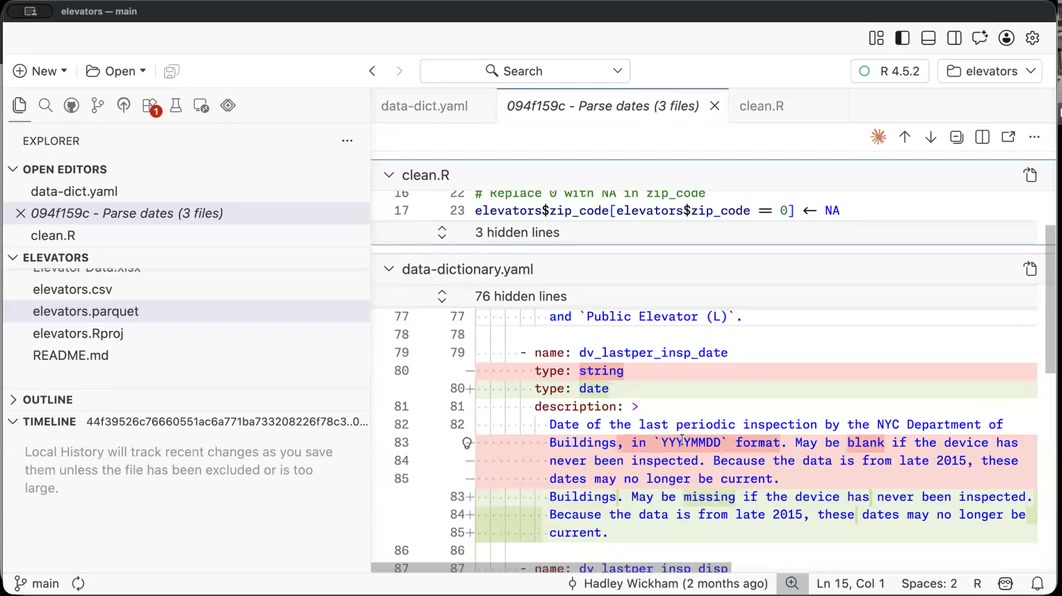
این هم نمونهٔ دیگر. در این تغییر، تاریخها را تجزیه (parse) کردم. پیش از تغییر میبینید که همهٔ ستونهای تاریخ صرفاً بهصورت رشته با قالب YYYY-MM-DD فهرست شده بودند. پس از آن، Claude کدی نوشته که این ستونهای کاراکتری را به ستونهای تاریخ تبدیل میکند، پس اکنون تاریخهای واقعی داریم. حالا وقتی آنها را رسم میکنیم یا میانگین یا سایر آمارههای خلاصه را حساب میکنیم، بهجای کار با رشتهها، خلاصههای درست میگیریم. و باز میتوانیم خیال خود را راحت کنیم که Claude کار را درست انجام داده، چون هم تغییر در کد را میبینیم و هم تغییر در فرهنگ داده را.
تنها چیزی که اینجا کم است — تنها عیب فایلهای parquet نسبت به فایلهای CSV — این است که در حال حاضر راهی برای دیدن diff یک فایل parquet وجود ندارد. این به نظرم بسیار مهم است، چون وقتی هوش مصنوعی کد مینویسد، میخواهید دقیقاً ببینید با دادههایتان چه کرده است. پس این چیزی است که امیدوارم در آینده پیادهسازی کنیم: علاوه بر تغییرات کد و تغییرات فرهنگ داده، بتوانید مرور کنید و دقیقاً ببینید در خود داده چه چیزی تغییر کرده است.
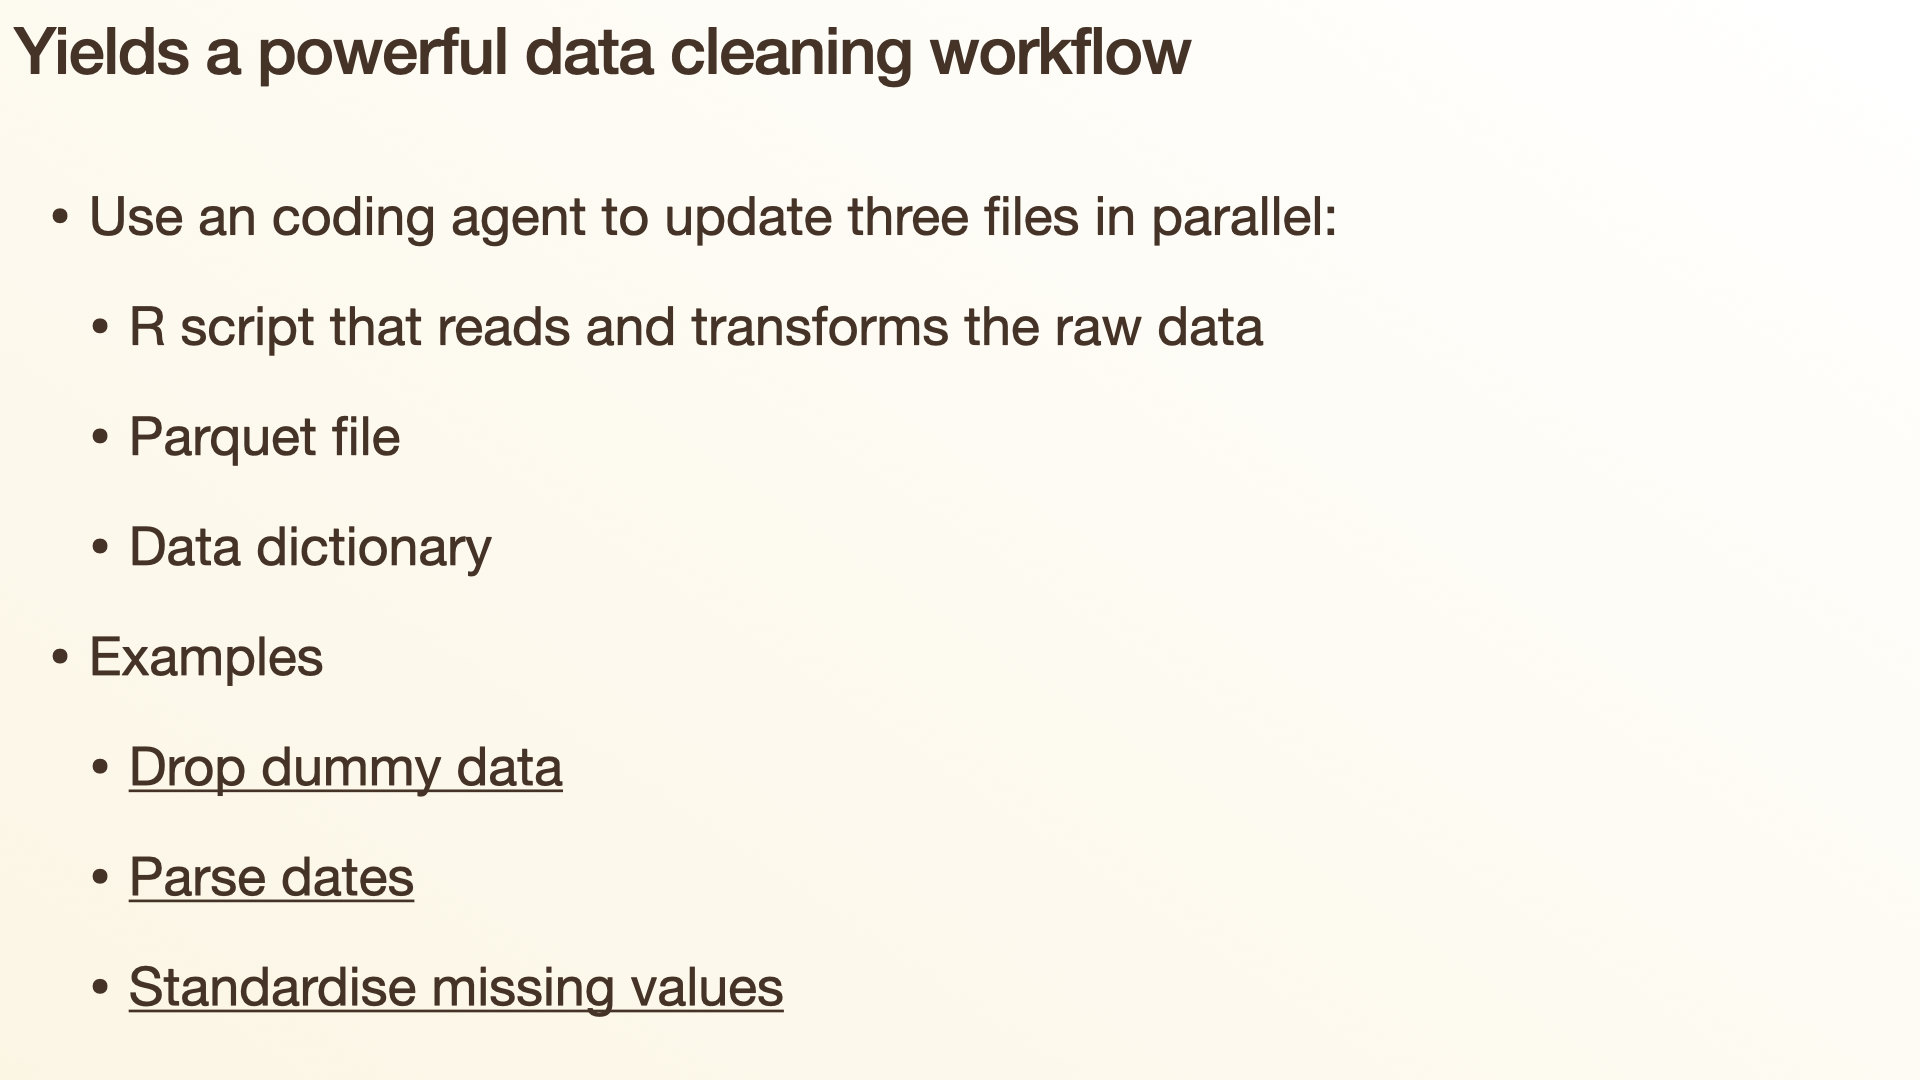
فکر میکنم این الگویی واقعاً جالب و قدرتمند است: با نمایش آنچه مدل زبانی انجام داده به شیوههای گوناگون، برایمان آسانتر است که خیالمان را از درست بودن کار راحت کنیم تا زمانی که فقط به یک نمایش نگاه میکنیم. این همان چیزی است که نشانتان دادم: وقتی پاکسازی داده میکنید، اکنون جریان کاریای دارید که از او میخواهید تاریخها را تجزیه کند یا مقادیر گمشده را درست کند، و میتوانید دقیقاً ببینید در همهٔ نمایشها — اسکریپت R، فایل parquet و فرهنگ داده — چه کرده است.
ابزار دیگری که اخیراً روی آن کار میکنیم ggsql است. اگر نام ggplot و SQL را شنیده باشید، بهراحتی میتوانید حدس بزنید ggsql چیست: فقط نحو (syntax) ggplot2 است که بهصورت SQL بیان شده. اگر با R یا پایتون آشنا باشید، احتمالاً فکر میکنید: خب، چرا باید چنین چیزی بخواهم؟ و این موضع کاملاً معقولی است. اما تعداد بسیار زیادی از افراد هستند که فقط SQL بلدند و R یا پایتون نمیدانند، و این افراد تا کنون چارچوب بصریسازی خوبی نداشتهاند.
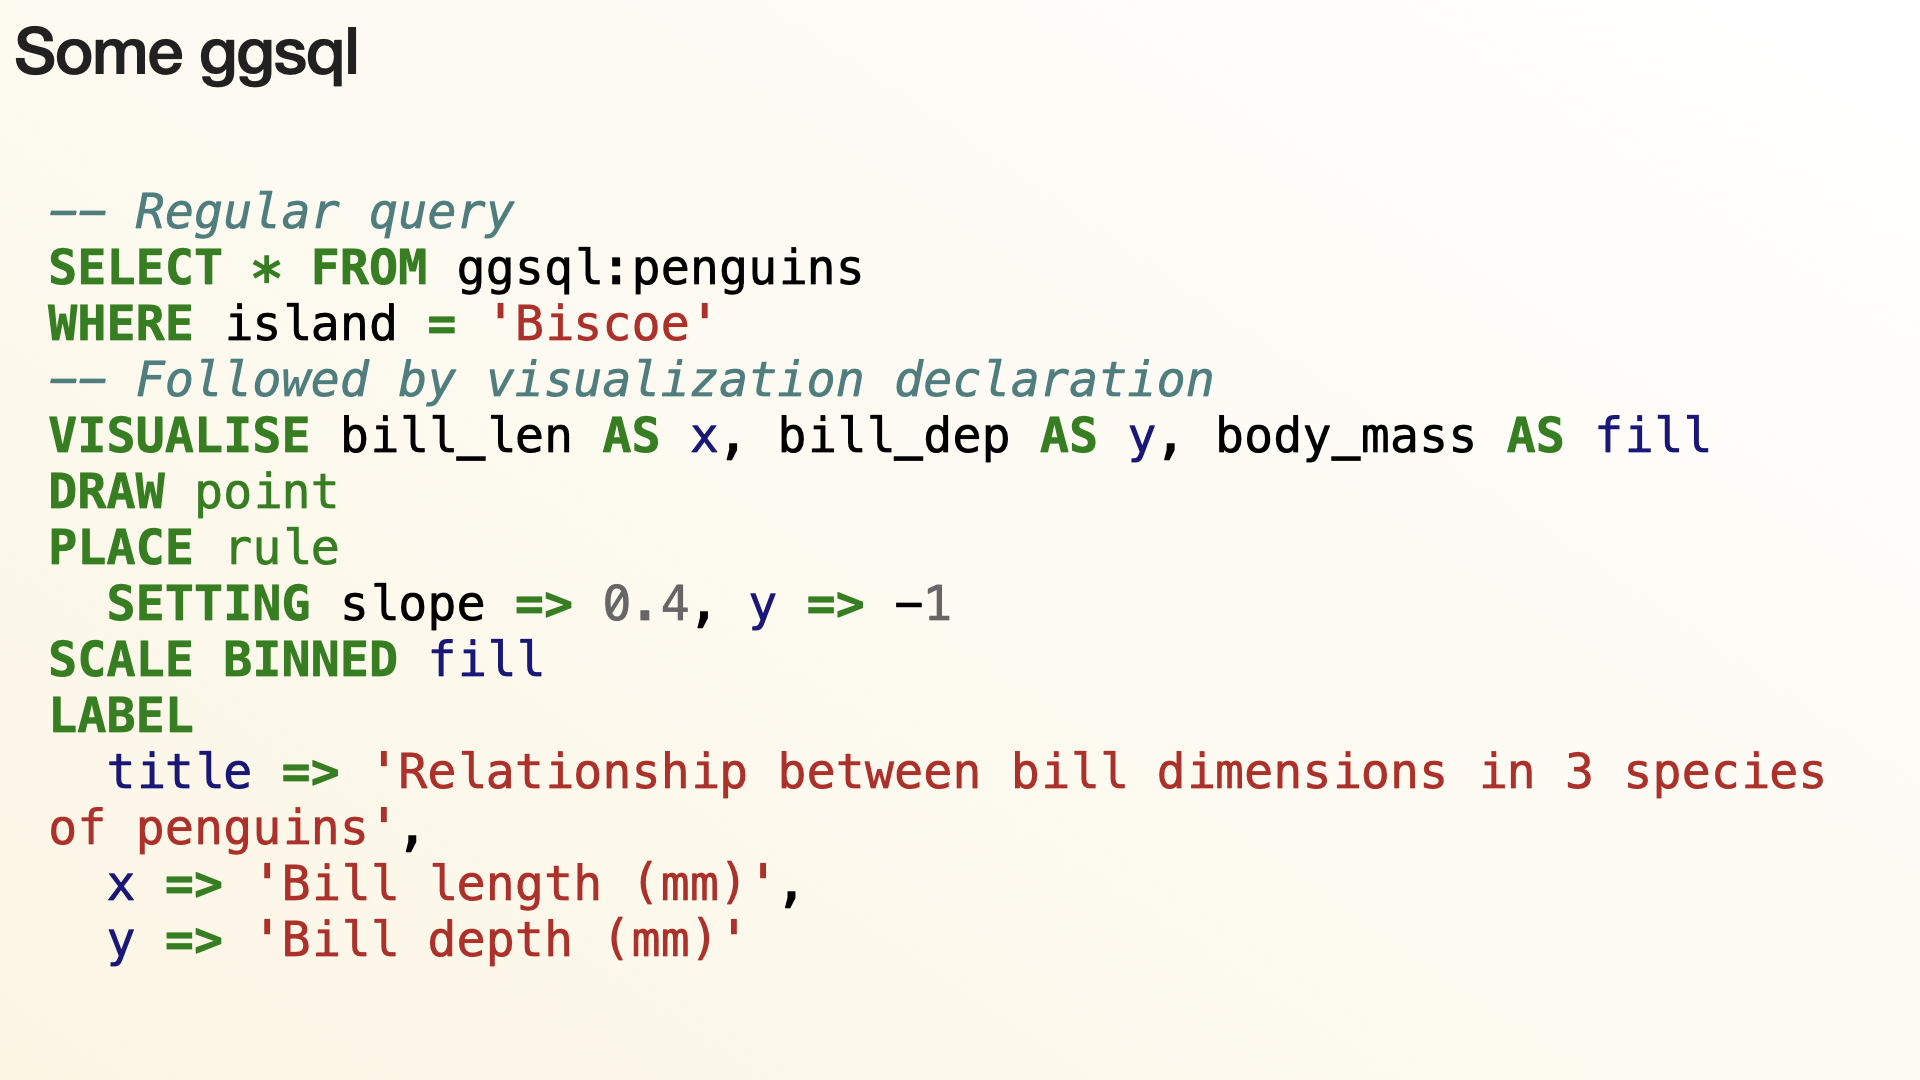
پس اکنون میتوانید کد SQL بنویسید که بصریسازی میسازد، همانطور که میتوانید کد ggplot2 را در R یا کد plotnine را در پایتون بنویسید. این قدرتمند است، چون به مردم کمک میکنید از رابط گرافیکی «کلیک و اشاره» به سمت متن حرکت کنند — و متن عالی است، چون هوش مصنوعی میتواند برایتان آن را بنویسد، میتوانید diff بگیرید تا ببینید چه تغییر کرده، و دیگران میتوانند آن را بخوانند و بازبینی کنند.
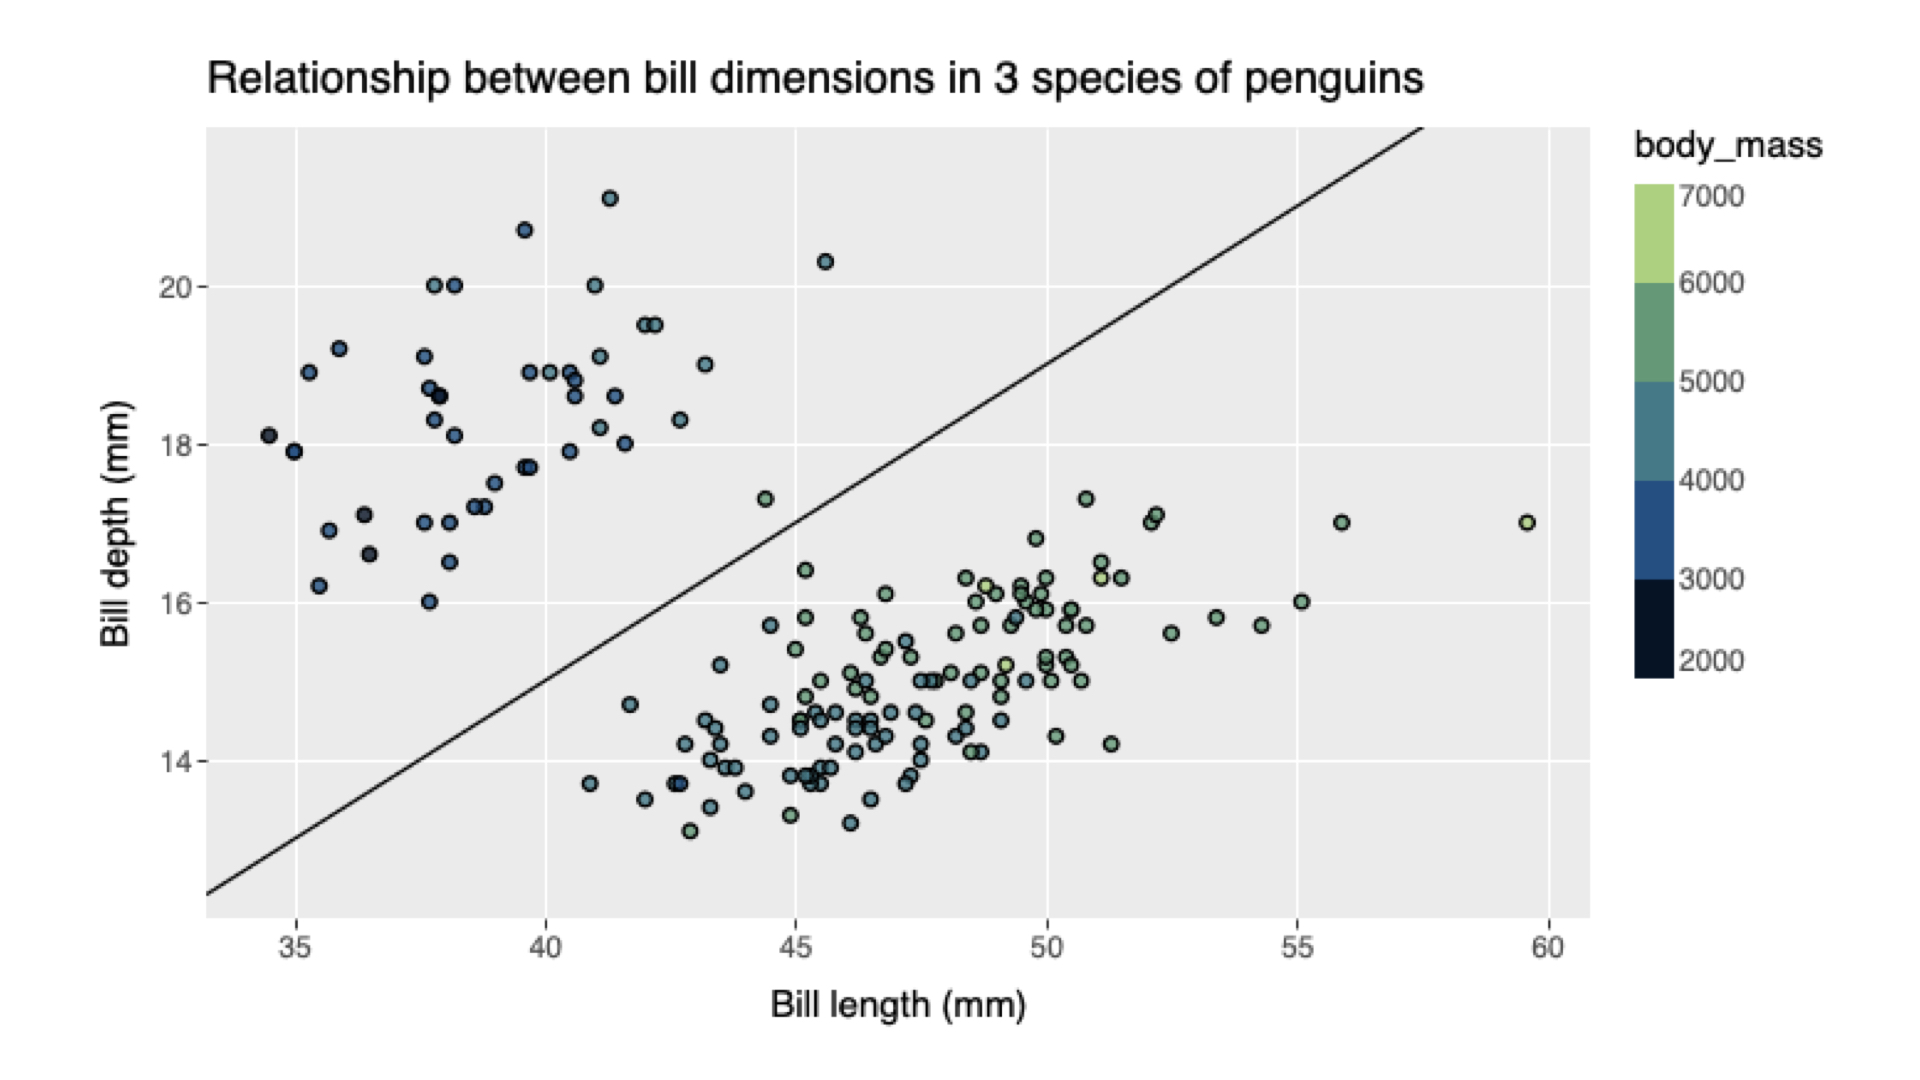
و این نوع نموداری است که ggsql میسازد، که تعجبی ندارد شبیه چیزی باشد که از ggplot2 میبینید.
دو جنبهٔ دیگر این کار را به هوش مصنوعی پیوند میدهد. اولی این است که اگر از مدل زبانیتان میخواهید کدی برای ساختن نمودار تولید کند و این کار را با R یا پایتون میکنید، باید بتواند کد R یا پایتون اجرا کند — و کد R یا پایتون میتواند هر کاری بکند. در بسیاری از سناریوها این اشکالی ندارد: اگر فقط روی رایانهٔ خودتان کاوش میکنید، از او کار عجیبی نمیخواهید و احتمالاً عمداً با مهندسی پرامپت وادارش نمیکنید همهٔ فایلهای رایانهتان را پاک کند. اما قطعاً این قدرت در دسترس اوست. یکی از مزیتهای ggsql این است که فقط SQL است، پس مدل زبانی میتواند آن را تولید کند و ما بتوانیم آن را بدون نیاز به اجرای کد دلخواه بصریسازی کنیم.
نکتهٔ دیگر، که کمتر آشکار است، این است که این پروژهای بود که میتوانستیم در پنج یا ده سال گذشته هر زمان انجامش دهیم، اما ندادیم، چون کار بسیار زیادی میطلبید — احتمالاً یک سال کار تا به نقطهای برسیم که بپرسیم: آیا مردم واقعاً به این اهمیت میدهند؟ اکنون با هوش مصنوعی میتوانیم آزمایش را بسیار سریعتر اجرا کنیم. میتوانیم ابزاری تولید کنیم که دیگرانِ ناآشنا با R یا پایتون بتوانند از آن استفاده کنند، و این کار را در حدود سه ماه بهجای یک سال انجام دهیم، سپس بازخورد بگیریم و تکرار کنیم. و واکنش به ggsql تا اینجا عالی بوده است، پس چیزی است که به سرمایهگذاری روی آن ادامه خواهیم داد.
نتیجهگیری
پس برای جمعبندی: این تصویر کلان را به شما دادم. غول از چراغ بیرون آمده و نمیتوانیم آن را به داخل برگردانیم. اما همهاش خبر بد نیست، چون دستکم برای من، کار با هوش مصنوعی میتواند فوقالعاده توانمندساز و سرگرمکننده باشد. بخش بزرگی از آن حول تغییر هویت من میگردد: اینکه توسعهدهندهٔ نرمافزار و دانشمند داده بودن چه معنایی دارد، و معرفی یک همکار تازه که به من کمک میکند حجم زیادی کد بنویسم.
اما همچنان قطعاً «آنچه میدهید همان است که میگیرید». بیش از هر زمان دیگری مهم است که جزئیات را جدی بگیرید، عمیق بروید و از نظر فکری درگیر بمانید. و باور دارم میتوانید از این طریق بهترین کار دوران حرفهایتان را تولید کنید.
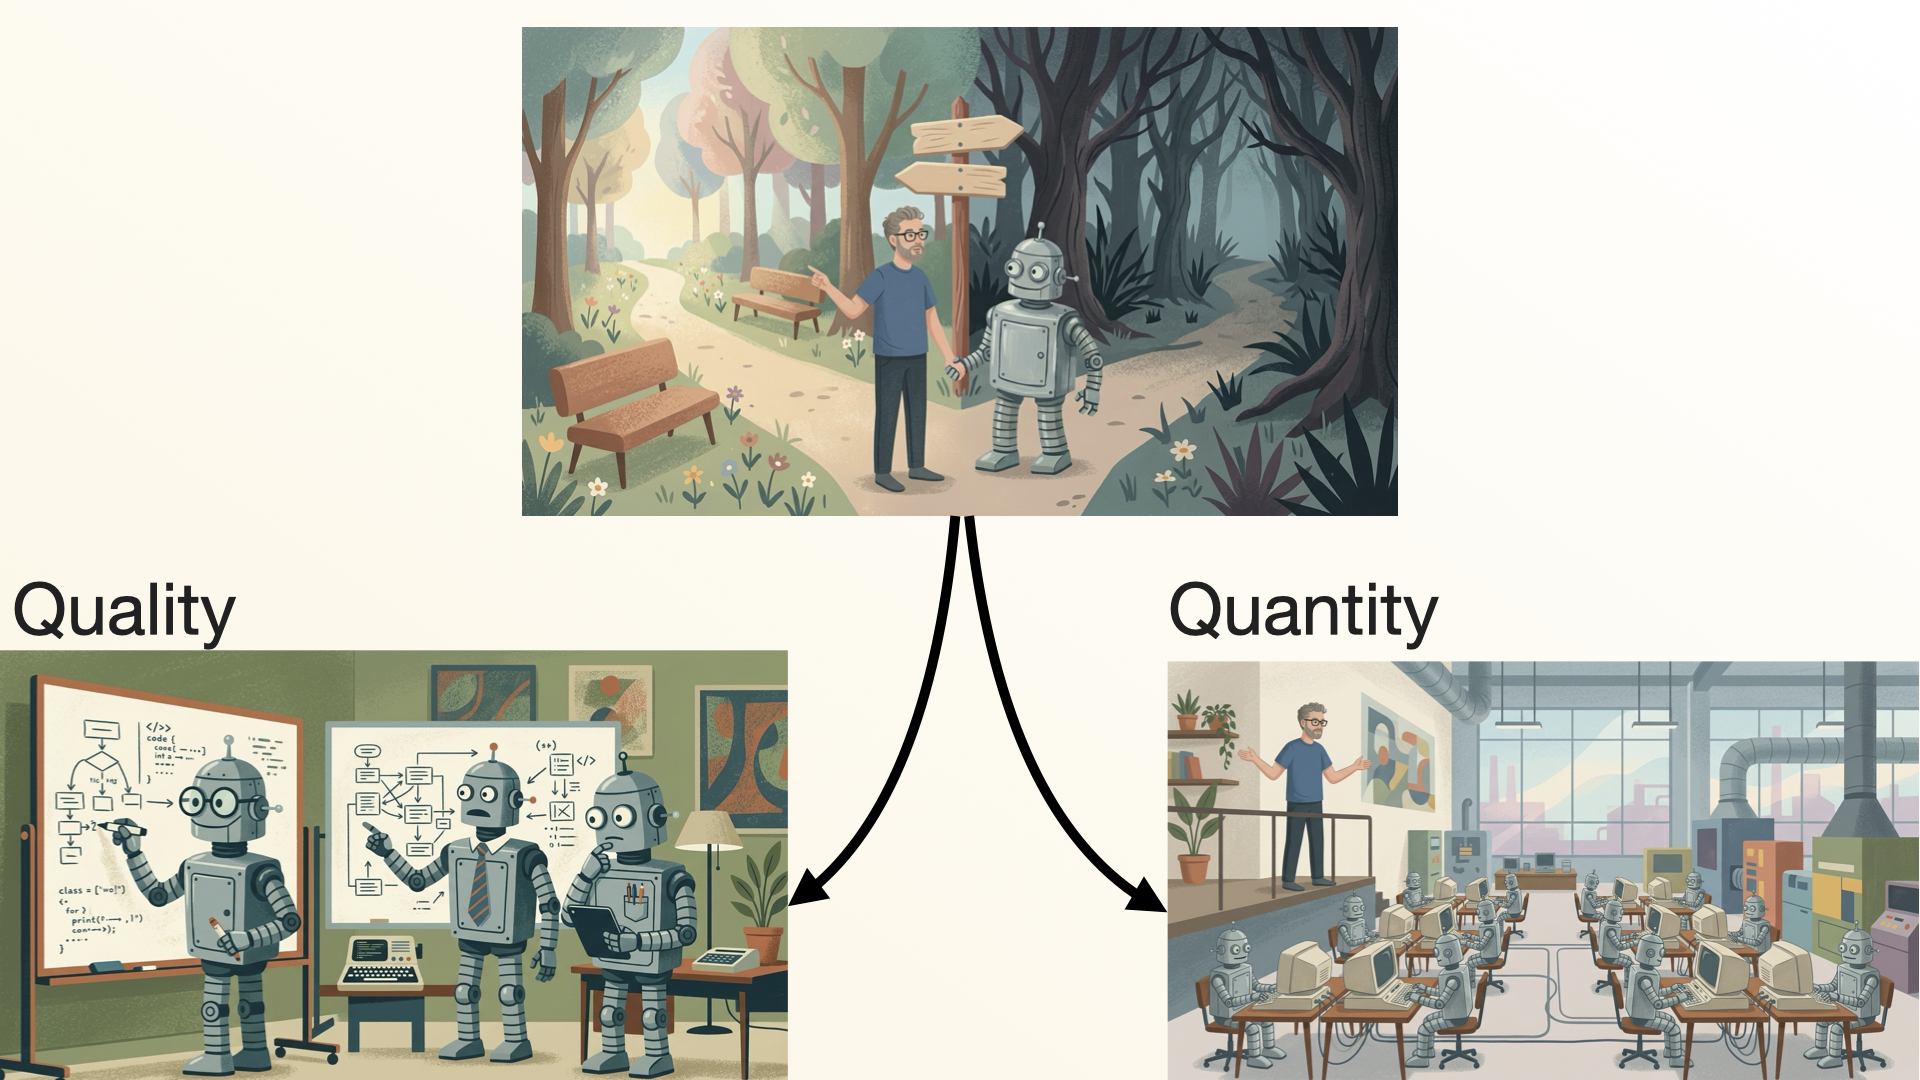
بسیار مهم است که به یاد داشته باشید میان کیفیت و کمیت انتخاب دارید — و این انتخاب یا این یا آن نیست. قطعاً مواقعی هست که فقط باید سریع چیزی را نمونهٔ اولیه (prototype) کنید. یکی از کارهایی که در آن از Claude استفاده میکنم و اصلاً به کیفیت کد اهمیت نمیدهم، ساختن سریع یک برنامهٔ Shiny است. ساختن برنامهٔ Shiny اکنون عملاً رایگان است؛ میتوانید برای پاسخ به یک پرسش ریز یکی بسازید. همین روزها در یک تحلیل داده این کار را کردم: داشتم تحلیل خوشهبندی انجام میدادم و دستی بررسی میکردم که با چهار خوشه چه شکلی میشود؟ با هشت خوشه چه؟ و فکر کردم، باید فقط یک برنامهٔ Shiny بسازم. Claude میتواند این کار را بکند — یک لغزنده (slider) به من بدهد تا بتوانم آن را به اینسو و آنسو بکشم و خروجی را ببینم. به آن برنامهٔ Shiny اهمیتی نمیدهم؛ کیفیتش مهم نیست. این جای عالیای است که سرعت، یا کمیت، مهمتر است.
اما برای کارهایی که واقعاً به آنها اهمیت میدهید و برای رشد حرفهایتان مهماند، میتوانید روی کیفیت عمیقاً سرمایهگذاری کنید. میتوانید از هوش مصنوعی برای موشکافی ایدهها و کدتان استفاده کنید و کار باکیفیت تولید کنید. چون در پایان روز، هوش مصنوعی یک تقویتکننده است. و از شما بهشدت میخواهم، تا جایی که توانش را دارید، از آن برای تقویت بهترین بخشهای خودتان، انسانیترین بخشهایتان، استفاده کنید — نه تنبلترین بخشتان.
متشکرم!
اگر تا انتها خواندید، دوست دارم بدانم دربارهٔ این قالب چه فکر کردید 🙂. آیا دوست دارید در آینده سخنرانیهای بیشتری از من را به این شکل ببینید؟